25.01.2023

So diskriminiert KI: ChatGPT entfacht Debatte neu

Jasmin Reisinger und Gabriele Bolek-Fügl erklären, wie Diskriminierung in der Künstlichen Intelligenz und in der KI-Branche funktionieren und was man dagegen tun könnte. Der Fall ChatGPT hat die Debatte neu entfacht.
/artikel/so-diskriminiert-ki-chatgpt-entfacht-debatte-neu
Gabriele Bolek-Fügl und Jasmin Reisinger (Women in AI Austria) sprechen über ChatGPT und Ethik in der KI © Bolek-Fügl; Reisinger; Parradee/AdobeStock

Die Kritik um ChatGPT und die Möglichkeit, rassistische oder sexistische Statements im Zuge der Nutzung zu erhalten, gibt es bereits länger. Mittlerweile hat sich die Debatte über die ethischen Aspekte der Künstlichen Intelligenz (KI) erweitert. Der Chatbot wurde soweit trainiert, dass scheinbar keine diskriminierenden Statements mehr vorkommen. Die erfolgreiche Behebung hat seinen Preis. Wie Recherchen des Time Magazins zeigen, hat die hinter ChatGPT stehende Firma OpenAI Textausschnitte an das Trainingsdatenunternehmen Sama gesendet, um die KI zu trainieren. Klickarbeiter:innen der Sama-Außenstelle in Kenia wurden dafür laut Time Magazin nicht nur mit unter zwei Dollar die Stunde für ihre Arbeit bezahlt, sondern waren mit teils traumatisierenden Inhalten konfrontiert. Um eine KI manuell zu trainieren, braucht es nämlich Menschen, die die toxischen Inhalte als solche klassifizieren und der KI übermitteln. 

Solche Skandale werfen Fragen auf: Wie können einer KI diskriminierende, sexistische und rassistische Inhalte abtrainiert werden, ohne zugleich in der realen Welt prekäre Arbeitsbedingungen zu bestärken? Im gemeinnützigen Verein “Women in Artificial Intelligence Austria” setzen sich mehrere AI-Expertinnen nicht nur mit den technologischen Aspekten, sondern auch mit der Geschlechterlücke in der Künstlichen Intelligenz auseinander. Damit widmen sie sich einer speziellen Form der Diskriminierung in der KI. Im brutkasten-Gespräch bewerten Jasmin Reisinger und Gabriele Bolek-Fügl von “Women in AI” den Fall ChatGPT und erklären die technologischen Hintergründe und was man in der Branche beachten muss, sodass gerechte Rahmenbedingungen herrschen – sowohl in der Technologie, als auch in der Realität.


Was ist Diskriminierung in der AI und wie findet sie aktuell statt?

Jasmin und Gabriele: Eine Künstliche Intelligenz lernt selbständig auf Basis von sehr vielen Datensätzen, die der Mensch bereitstellt. Diese Datensätze bilden entweder eine Momentaufnahme ab, die die bisherige Realität darstellt – inklusive der Diskriminierung von einzelnen Menschengruppen. Oder sie bilden eine Situation ab, von der umfassende Datensätze vorhanden sind. Bei zweiterem bedeutet dies, dass selten eine ausgewogene Bandbreite der Menschen in den Daten vorhanden ist. Außerdem werden die KI-Modelle von einer homogenen Gruppe von Programmierer:innen erstellt. Auch das ist eine Quelle dafür, dass sich Vorurteile in den Ergebnissen von KI-Systemen widerspiegeln.

Diskriminierung im Kontext von KI bedeutet demnach, dass Interpretationsmuster vom Menschen übernommen werden können. So können negative Diskriminierungsstrukturen entstehen. Um dies zu vermeiden, müssen Trainingsdaten „bereinigt“ oder „ergänzt“ werden und das ist bei Millionen von Datensätzen keine einfache Aufgabe. Vor dieser Herausforderung steht aktuell OpenAI und deren Chatbot “ChatGPT”, der für sein Können bestaunt und für seine Limitierungen kritisiert wird.

Wie beobachtet bzw. bewertet ihr diesen Sachverhalt rund um OpenAI und deren Umgang mit externen Angestellten?

Jasmin: Der Time-Artikel zu OpenAI hat bestimmte Vorgänge im Hintergrund sehr detailliert beleuchtet, die der breiten Öffentlichkeit vorher unbekannt waren. Wie bereits erwähnt ist die Bereinigung von riesigen Datensätzen eine Herausforderung, zu der es oft (noch) keine einfache Lösung gibt. Dabei sind zwei Perspektiven zu beachten: Einerseits sollte die KI-Industrie bei heiklen Datensätzen nicht auf einfache Lösungen zurückgreifen, die auf der Ausbeutung billiger Arbeitskräfte beruhen, um schnellen technologischen Fortschritt zu erreichen. Andererseits ist die Involvierung von diversen Personengruppen mit unterschiedlichen Lebensrealitäten zu begrüßen, da sie für ausgewogenere KI-Modelle stehen können.

Gabriele: Die Reaktion der Öffentlichkeit wird OpenAI langfristig dazu zwingen, ethisch unbedenkliche Wege zu finden, wie sie ihre Technologie weiterentwickeln können. Ethische Beurteilungen unterliegen immer einem gesellschaftlichen Diskurs und da stehen wir noch ganz am Anfang. Es ist jedenfalls zu begrüßen, dass die Daten von ChatGPT nach unterschiedlichen Kriterien beurteilt und bereinigt wurden. KI-Systeme anderer Hersteller mussten aufgrund von nicht ausreichend bereinigten Daten bald wieder deaktiviert werden. Ethik ist nicht einfach da. Ethische KI-Systeme bedeuten die Abbildung der gesellschaftlichen Meinung zu einem bestimmten Zeitpunkt, und diese kann sich rasch ändern. Und es bedeutet viel Arbeit, diese Meinung in tausenden Datensätzen abzubilden.

Jasmin: Ich möchte an dieser Stelle jedoch betonen, dass nicht alle KI-Systeme mit Hochrisiko-Datensätzen gefüttert werden (müssen). Die Qualitätssicherung in der Glasindustrie z.B. ist weit weg von Themen wie Rassismus oder Sexismus, und verbessert tatsächlich die Arbeitsprozesse für Arbeitnehmer:innen. Den Fall OpenAI werden wir weiterhin beobachten.

Viele Menschen vergessen bei Künstlicher Intelligenz die manuellen Aspekte – also die Content Moderation hinter der Menschen stehen, die ungefiltert mit sämtlichen Daten konfrontiert werden. Teilweise kann das auch zu einer psychischen Belastung für Arbeitnehmer:inenn führen. Wie kann man sich diese manuellen Aspekte vorstellen?

Jasmin: Um Datensätze als Basis für KI-Systeme nutzen zu können, müssen diese einem „Labeling“ unterzogen werden. Der Mensch kennzeichnet dann z.B. die Merkmale einer Katze, damit die KI lernt, woran sie eine Katze erkennen oder von einem Hund unterscheiden kann.

Bei Millionen von Datensätzen muss z.B. im Falle von OpenAI gekennzeichnet werden, welche Daten diskriminierend, rassistisch, sexistisch usw. sind, um qualitativ hochwertige, wertfreie Datensätze zu erzielen. Erst dann kann die KI „gute“ Ergebnisse liefern. Vor- oder Nachteile gibt es in dem Sinne nicht. Der steigende Bedarf an „Data Labeling“ wird viele Unternehmen lediglich vor eine Herausforderung stellen.

Gabriele: Dass potentiell traumatisierende Informationen von Menschen angesehen werden müssen, um ein Daten Labeling für KI durchzuführen, ist der Realität geschuldet. Diese Daten wurden aus einem bestimmten Grund von Menschen erstellt. Dieser war nicht, als Trainingsdaten für eine KI herangezogen zu werden, sondern Angst, Betroffenheit oder Ähnliches bei anderen Personen zu erzeugen.

OpenAI ist nicht das erste und vermutlich nicht das letzte Unternehmen, bei dem so etwas vorkommt. Gerade in Anbetracht der Tatsache, dass wir jetzt auf einen AI-Hype blicken: Wie muss sich die AI-Branche verändern, damit solche Arbeitsbedingungen aufgehalten werden?

Gabriele: Wollen wir ethische KI-Systeme, so muss vorher ein gesellschaftlicher Diskurs zu den ethischen Werten stattfinden. Dann kann versucht werden, diese in den KI-Modellen abzubilden. Bekannt ist das Beispiel, ob ein selbstfahrendes Auto eher einen 80-jährigen Mann bei einer unausweichlichen Kollision verletzen soll oder die Mutter mit Kinderwagen.

Die Auslagerung des “Data Labeling” in andere Länder mit billigeren Kostenstrukturen und Lohn hat auch mehrere Aspekte. Aus Diversitätsgründen ist es einerseits zu begrüßen, außerdem werden so auch Arbeitsplätze mit für die Länder meist gutem Lohn geschaffen. Andererseits werden häufig jene Sachverhalte ausgelagert, die man den eigenen Angestellten nicht zumuten möchte. Das ist ethisch sicher bedenklich.

Da Millionen von Datensätzen gelabelt werden müssen, sind die KI-Unternehmen darauf angewiesen, in andere Länder auszuweichen, um die Kosten für die KI-Systeme nicht immens hoch werden zu lassen und die Arbeit parallel zur Entwicklung durchzuführen. Kosten KI-Systeme letztendlich zu viel, werden sie von nur wenigen Kund:innen genutzt. Es verzerrt den Wettbewerb noch mehr, wenn diese Methodik nur einem kleinen Benutzerkreis zur Verfügung steht, der sich hohe Kosten leisten kann.

Jasmin: Zusätzlich ist noch der geografische Aspekt zu beachten. In Europa herrscht im Gegensatz zu den USA ein Bestreben nach regulierten, vertrauenswürdigen KI-Systemen. Hier wird durchaus betont, dass sowohl in technischer als auch gesellschaftlicher Hinsicht, kein Schaden angerichtet, sondern ausschließlich positive wirtschaftliche und gesellschaftliche Beiträge geleistet werden sollen. Ein konkreter Rechtsrahmen fehlt zwar auch hier noch, aber die Richtung stimmt. Langfristig werden Länder wie die USA an Regulierungen und Leitlinien feilen müssen, wenn sie das Vertrauen der Benutzer:innen erlangen bzw. behalten wollen.

Deine ungelesenen Artikel:
21.10.2026

Grazer Deep-Tech-Spin-off DiLT Analytics schließt siebenstellige Finanzierungsrunde ab

Das Grazer TU-Spinoff holt den Deep-Tech-Fonds Noctua Science Ventures als Investor an Bord und erhält zusätzlich eine Förderung aus dem Programm aws Seedfinancing – Deep Tech. Das Kapital soll in den Teamaufbau und in den Rollout der Diagnosesoftware FaciliMind fließen.
/artikel/grazer-deep-tech-spin-off-dilt-analytics-schliesst-siebenstellige-finanzierungsrunde-ab
21.10.2026

Grazer Deep-Tech-Spin-off DiLT Analytics schließt siebenstellige Finanzierungsrunde ab

Das Grazer TU-Spinoff holt den Deep-Tech-Fonds Noctua Science Ventures als Investor an Bord und erhält zusätzlich eine Förderung aus dem Programm aws Seedfinancing – Deep Tech. Das Kapital soll in den Teamaufbau und in den Rollout der Diagnosesoftware FaciliMind fließen.
/artikel/grazer-deep-tech-spin-off-dilt-analytics-schliesst-siebenstellige-finanzierungsrunde-ab
DiLT Analytics
© DiLT Analytics

DiLT Analytics hat eine siebenstellige Finanzierungsrunde abgeschlossen. Sie setzt sich aus einem Equity-Investment von Noctua Science Ventures und einer Förderung der Austria Wirtschaftsservice (aws) im Rahmen des Programms Seedfinancing – Deep Tech zusammen. Mit dem Geld möchte das 2021 gegründete Spinoff der TU Graz sein Team ausbauen und FaciliMind, seine Software zur automatisierten Fehlerdiagnose in Heizungs-, Lüftungs- und Klimaanlagen, zu weiteren Betreibern großer Gebäudeportfolios bringen

DiLT Analytics: „Substanziell wachsen“

Noctua Science Ventures ist ein Wiener Deep-Tech-Fonds und ein Joint Venture von Speedinvest und den Technischen Universitäten Österreichs. Der Fonds investiert gezielt in Ausgründungen, deren Produkt auf langjähriger Forschung beruht.

„Die aws-Förderung ergänzt das Investment und ist auf genau diese Phase zugeschnitten: den Schritt von einer erprobten Technologie zu einem Produkt, das sich über viele Standorte hinweg ausrollen lässt“, heißt es per Aussendung. Um im Sinne des Programms aws Seedfinancing – Deep Tech als Deep Tech zu gelten, muss das Vorhaben auf einer „anspruchsvollen technologischen und wissenschaftlichen Herausforderung“ basieren und einen klaren Technologiesprung gegenüber bestehenden Lösungen oder rein inkrementellen Weiterentwicklungen ermöglichen.

„Mit Noctua Science Ventures haben wir einen Partner gefunden, der beides kennt: die technischen Herausforderungen eines Deep-Tech-Produkts und den Weg in die Kommerzialisierung. Für ein junges Spinoff ist das der Best Case. Dass parallel auch die aws-Förderung zugesagt wurde, bestätigt uns, dass FaciliMind und unser Team auf dem richtigen Weg sind. Jetzt geht es darum, substanziell zu wachsen“, sagt Theresa Kohl, CEO von DiLT Analytics.

Philipp Stangl, Managing Director von Noctua Science Ventures, ergänzt: „Von unseren vielen Gesprächspartnern erhielten wir ein sehr einheitliches Bild zu DiLT: ein glaubwürdiger, technisch differenzierter Ansatz, umgesetzt von einem Team, mit dem Immobilienprofis gerne zusammenarbeiten. Genau diese Kombination aus Forschungsvorsprung und starker Kundenorientierung ist es, wonach wir in der Pre-Seed-Phase suchen.“

2021 gegründet

DiLT Analytics wurde Ende 2021 von Franz Wotawa und Gerald Schweiger als Spinoff des Instituts für Softwaretechnologie der TU Graz gegründet und ging aus der Forschungsgruppe „Intelligent Systems“ hervor. Erstes größeres Projekt war „Inframonitor“, eine herstellerunabhängige IoT-Datenplattform für den Campus Inffeldgasse der TU Graz.

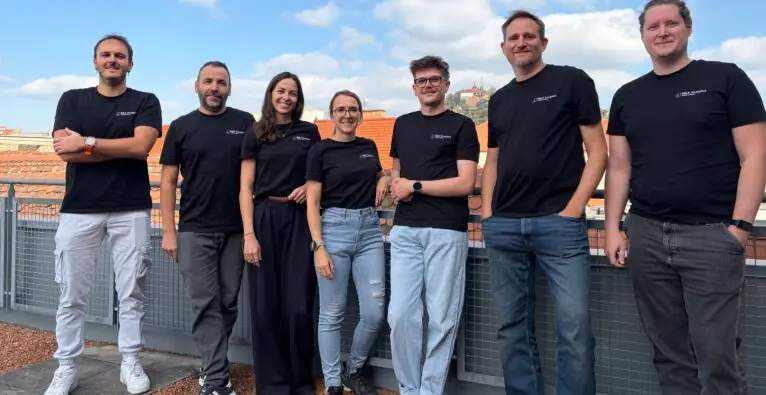
Seither ist DiLT an mehr als 20 Forschungsprojekten mit über 15 Partnern beteiligt, einige davon FFG-gefördert und gemeinsam mit österreichischen und europäischen Universitäten. Die Ergebnisse fließen über den Forschungszweig DiLT Research direkt in die Produktentwicklung. Geführt wird das Unternehmen heute von Theresa Kohl (CEO), Christopher Gray (Business Development & Strategy), Thomas Hirsch (CTO), Reinhard Pertschy (CPO) und Thomas Schwengler (Head of Software).

Die entwickelte Software FaciliMind analysiert Betriebsdaten von Heizungs-, Lüftungs- und Klimaanlagen, erkennt dabei versteckte Fehler und Optimierungspotenziale und liefert Technikteams eine nach Dringlichkeit sortierte Maßnahmenliste, so der Claim. Die Software von DiLT Analytics arbeitet herstellerunabhängig und lässt sich über ein einzelnes Gerät an die bestehende Gebäudeleittechnik anbinden. Dank eines knowledgegraphbasierten Softwarestacks soll sie das digitale Abbild komplexer Anlagen weitgehend automatisiert innerhalb weniger Tage statt monatelanger Handarbeit erstellen können. Zielgruppe sind Betreiber großer Gebäudeportfolios, etwa in der öffentlichen Hand, an Flughäfen sowie in Industrie und Gesundheitswesen.

DiLT Analytics erhielt Preise

Zu den Kunden zählen u.a. die Technischen Universitäten Graz und Wien, Bundesimmobiliengesellschaft (BIG), IG Immobilien Management GmbH und Industriekunden. 2025 wurde DiLT Analytics mit dem DREA Award und dem ÖGUT Umweltpreis ausgezeichnet. Und ist seit September 2026 nach ISO 27001 zertifiziert.

„Wissen über Anlagenbetrieb soll im Unternehmen bleiben“

Neben der Verstärkung des Teams und dem geplanten Rollout möchte DiLT Analytics künftig ein Übersetzungswerkzeug für den BACtwin-Standard als Open Source veröffentlichen und die Diagnose künftig auf weitere Technologien wie Wärmepumpen, Photovoltaik und Batteriespeicher ausweiten

„Ein Gebäudeportfolio überdauert seine Dienstleister und oft auch seine erfahrensten Mitarbeitenden“, sagt Kohl. „Unser Ziel ist, dass das Wissen über den Anlagenbetrieb im Unternehmen bleibt und dass Entscheidungen auf verifizierter Datengrundlage statt auf Bauchgefühl und Erinnerung beruhen.“

Toll dass du so interessiert bist!
Hinterlasse uns bitte ein Feedback über den Button am linken Bildschirmrand.
Und klicke hier um die ganze Welt von der brutkasten zu entdecken.

brutkasten Newsletter

Aktuelle Nachrichten zu Startups, den neuesten Innovationen und politischen Entscheidungen zur Digitalisierung direkt in dein Postfach. Wähle aus unserer breiten Palette an Newslettern den passenden für dich.

Montag, Mittwoch und Freitag

AI Summaries

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Welche gesellschaftspolitischen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Welche wirtschaftlichen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Innovationsmanager:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Investor:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Politiker:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Was könnte das Bigger Picture von den Inhalten dieses Artikels sein?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Wer sind die relevantesten Personen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Wer sind die relevantesten Organisationen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu