07.07.2023

Diese drei Fragen sollten Investor:innen KI-Startups stellen

Gastbeitrag. Worauf Investor:innen achten soll, wenn sie sich Startups im Bereich Künstliche Intelligenz (KI) ansehen, erläutert Simon Brendel von dem auf Tech-Due-Dilligence spezialisierten Beratungsunternehmen Philipps & Byrne.
/artikel/fragen-investoren-ki-startups
Simon Brendel, Philipps & Byrne
Simon Brendel, Philipps & Byrne | Hintergrund: Adobe Stock

Künstliche Intelligenz (und insbesondere Generative AI) gilt aktuell als einer der wenigen Bereiche, die dem allgemeinen Downturn in der Startup-Szene standhalten. Investments in AI sind vergleichsweise stabil und es entstehen immer mehr KI-Startups. VCs, die ihren Dealflow prüfen, stellen sich dabei natürlich oft die Frage, ob die Qualität des Machine-Learning-Setups tatsächlich hält, was das Pitchdeck oder die Equity Story verspricht. In diesem Artikel empfehle ich drei Fragen, die jeder VC auf dem Schirm haben sollte, wenn er sich ein KI-Startup anschaut.

Erste Frage: Handelt es sich wirklich um ML oder um ein traditionelles regelbasiertes System?

Zu Anfang sollte man einmal klären, ob das Startup wirklich mit Machine Learning arbeitet oder eher mit einem selbstentwickelten, regelbasierten System. Ist das System selbstlernend und verbessert es sich, wenn es mit mehr Daten trainiert wird? Dann handelt es sich um ML. Darüber hinaus umfasst selbstlernende ML auch selbstüberwachte oder unüberwachte Methoden. Die Frage, ob und wie man eine solche Selbstverbesserung am besten ermöglicht, wird als „Online-Lernen“ bezeichnet.

Wenn es sich um ein System handelt, das nach bestimmten Regeln arbeitet, die von Entwicklern im Voraus festgelegt werden, und das nicht mit Daten oder selbstlernend trainiert wird, ist das in der Regel keine echte KI – zumindest nicht im aktuellen Verständnis.

Zweite Frage: Make or Buy?

Die zweite Frage lautet: Wurde das ML-Modell selbst entwickelt oder wird ein Open-Source- oder proprietäres Modell von Drittanbietern genutzt? Wenn es sich um Open-Source-Modelle handelt, passen die Unternehmen diese Modelle sehr oft für den eigenen Business-Case an. In diesem Fall wird nicht wirklich etwas von Grund auf neu entwickelt, aber es wird auch nicht einfach etwas übernommen, das bereits existiert. Ein Beispiel wäre die jüngste Entwicklung von ChatGPT, bei der die GPT-Modelle von Open.AI verwendet werden können. Sie sind Open Source, und man kann sie unter bestimmten Lizenzmodellen für das eigene Business nutzen.

Die Unterscheidung besteht also darin, ob es sich um externe ML-Fähigkeiten handelt, die für das eigene Business-Modell genutzt und gegebenfalls angepasst werden, oder ob es sich um selbst entwickelte ML handelt. Bei Letzterem handelt es sich dann in der Regel um Deep-Tech-Startups, die eigene Foundation Models oder Large Language Models (LLM) entwickeln und in denen ein viel tieferes technologisches Wissen im Unternehmen vorhanden ist.

Dritte Frage: Mit welchen Daten wurde das ML-Modell trainiert und wem gehören sie?

ML-Modelle entwickeln sich zunehmend zu einer Ware. Der Zugang zu einem ML-Modell stellt also kein Differenzierungsmerkmal mehr für Startups dar. Die wirklich interessante Frage wird sein, von wem und auf welche Weise diese Modelle trainiert wurden. Und mit welcher Art und Menge von Daten.

Wenn das Unternehmen eigene Daten verwendet, gibt es zwei Dimensionen zu bedenken. Erstens: Die Menge der Datenpunkte im Datensatz. Es geht also darum, zu verstehen, wie statistisch signifikant bestimmte Effekte in diesem Datensatz sind. Ein größerer Datensatz ist immer interessanter, da statistische Fehler besser ausgeschlossen werden können und ein höheres Maß an Vertrauen entsteht. Dabei darf der Aspekt der Datenvielfalt nicht unterschätzt werden. Wie gut decken die verfügbaren Daten den Raum ab, in dem das Model lebt. Einige Unternehmen sind in der Lage, riesige Datensätze aus ihren eigenen Betrieben zu produzieren. Oft besteht aber das Problem, dass Datensätze zu klein sind, um wesentliche Verbesserungen in den Ergebnissen der AI zutage zu fördern.

Die zweite Dimension betrifft die Frage nach den Besitzverhältnissen der Daten. Wie ist das Unternehmen an diesen Datensatz gekommen? Ist er öffentlich zugänglich? Wurden sie von bestimmten Lieferanten bezogen? Oder werden sie vielleicht sogar von dem Unternehmen selbst gesammelt? Proprietäre Daten werden in den kommenden Jahren einen echten Wettbewerbsvorteil darstellen. Je privater der Datensatz ist, desto stärker sind die Fähigkeiten des Unternehmens, einen bestimmten Business Case zu bedienen und damit ein erfolgreiches Geschäftsmodell aufzubauen.

Fazit

Unterm Strich sollten VCs also folgende Fragen auf dem Schirm haben: Zuerst muss man herausfinden, ob das Unternehmen wirklich ML-Modelle vorweisen kann oder ob es sich um regelbasierte Systeme handelt. Zweitens müsste man klären, ob das Modell gekauft oder selbst entwickelt wurde. Und drittens muss hinterfragt werden, mit welchen Daten das Modell trainiert wurde. Und hier gilt: Je größer, vielfältiger und privater der Datensatz ist, desto besser für den Aufbau eines differenzierten Modells und den potenziellen Erfolg eines KI-Startups.


Über den Autor

Simon Brendel ist Director New Business beim Beratungsunternehmen Philipps & Byrne mit Sitz in Berlin, das auf Tech Due Diligence spezialisiert ist. Zur Zielgruppe des Unternehmens zählen Investo:innen, Growth-Stage-Startups und Unternehmer:innen. Brendel thematische Schwerpunkte sind unter anderem Themen Strategie, Technologie und Innovationen.

Deine ungelesenen Artikel:
08.10.2026

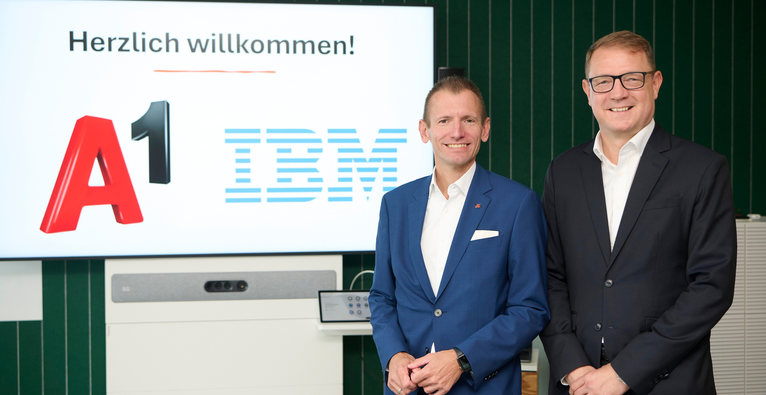
Neue Plattform von A1 und IBM: Sichere und digital souveräne KI-Agenten für Unternehmen

A1 und Exoscale machen die IBM-KI-Plattform watsonx ihren Unternehmenskunden zugänglich - und nutzen sie auch selbst. A1-CCO Martin Resel und IBM-Österreich-Chef Marco Porak erklärten die Hintergründe.
/artikel/neue-plattform-von-a1-und-ibm-sichere-und-digital-souveraene-ki-agenten-fuer-unternehmen
Vl. A1-CCO Martin Resel und IBM-Österreich-Chef Marco Porak | © A1/APA/Hörmandinger

Dass für Unternehmen kein Weg mehr an Agentic AI vorbeiführt, ist mittlerweile ein Gemeinplatz. Dass eine sichere und konforme Umsetzung davon nicht so einfach ist, ebenfalls. „Für KI im Unternehmenskontext gelten andere Spielregeln als im privaten Bereich. Ich spreche hier besonders von souveräner KI“, sagt Marco Porak, Generaldirektor von IBM Österreich, bei einem gemeinsamen Pressetermin mit A1 und dessen Cloud-Tochter Exoscale. Mit einer gemeinsamen Plattform, die IBM watsonx auf A1 Exoscale bringt, will man Unternehmenskunden gemeinsam eine sichere und digital souveräne Lösung bieten.

„Wir sind Teil der kritischen Infrastruktur“

Denn Schatten-KI, also die Nutzung privater bzw. vom Unternehmen nicht genehmigter KI-Anwendungen durch Mitarbeiter:innen, sei ein echtes Sicherheitsrisiko, betont Martin Resel, stv. Vorstandsvorsitzender von A1 und CCO Enterprise. „Unternehmen können es sich nicht leisten, KI nicht zu nutzen. Da geht es um Wettbewerbsfähigkeit. Alles muss effizienter werden, etwa auch in der Verwaltung. Wenn man dann aber Daten global findet, die eigentlich nicht global gespeichert werden sollten, ist das ein Problem“, sagt Resel.

Für viele A1-Unternehmenskunden und auch für A1 selbst sei das besonders relevant. „Wir sind Teil der kritischen Infrastruktur. Viele hochsensible Daten laufen auf unseren Netzen. Wir haben nicht nur Unternehmen aller Größen als Kunden, sondern zum Beispiel auch Ministerien“, sagt der A1-CCO. Gerade in der aktuellen geopolitischen Situation müssten sich Österreich und ganz Europa daher souverän aufstellen.

Orchestrierte KI-Agenten mit klaren Regeln und voller Transparenz

Und wie macht das die gemeinsame Plattform? „Ich bin mir bewusst, dass ich Repräsentant eines amerikanischen Unternehmens bin“, räumt Marco Porak ein. IBM habe aber nach nicht weniger als 98 Jahren am österreichischen Markt ein anderes Standing, als etwa die US-Hyperscaler. Warum? „IBM hat seit jeher das Prinzip, dass Kundendaten Kundendaten sind und die Architektur vom Kunden bestimmt wird“, so Porak. Und: „Globale Innovation und lokale Kontrolle widersprechen einander nicht.“ Genau so sei es auch bei watsonx. Kunden können dort entscheiden, welche KI-Modelle genutzt werden und wo die Daten liegen. Die Bandbreite geht dabei von lokal gehosteten On-Premise-Lösungen über europäische bzw. Open-Source-Modelle auf europäischen Servern bis zu Frontier-Modellen in Datencentern der US-Hyperscaler.

Konkret greift das System auf eine Vielzahl an Large Language Models (LLMs) und Agentic-Modelle zurück und orchestriert KI-Agenten, um Tasks zu erfüllen. Die dazugehörige Governance-Plattform ermöglicht nicht nur das Festlegen der Regeln dafür, sondern bietet auch jederzeit komplette Transparenz, um jeden Arbeitsschritt und die dafür genutzten Modelle nachvollziehen zu können. Für Martin Resel ist dabei ebenfalls klar: „Dass alles, was aus Asien oder Amerika kommt böse ist, sehen wir nicht so. Wichtig ist die Wahlfreiheit.“ Die Plattform sei daher offen für sämtliche Modelle.

„Wir folgen einer sehr strikten Datenklassifizierung – selber und auch für unsere Kunden“

Je nach Usecase und dem damit verbundenen Sicherheits-Level der Daten seien unterschiedliche LLMs und Speicherorte sinnvoll. „Wir folgen einer sehr strikten Datenklassifizierung – selber und auch für unsere Kunden“, sagt Resel. Nach dieser erfolge die Entscheidung, welche Modelle genutzt werden können. Gleichzeitig optimiere die Plattform durch die passende Modell-Auswahl auch den Token-Verbrauch. „Das kann sonst bekanntlich schnell teuer werden“, sagt der A1-CCO.

A1 bietet seinen Enterprise-Kunden nicht nur Zugang zur Plattform, sondern auch begleitende Services, um diese aufzusetzen. Mit den europäischen Datencentern der Tochter Exoscale kommt noch das Angebot der souveränen Cloud im eigenen Land hinzu.

Wie watsonx für A1 und seine Kunden konkret funktioniert, zeigt Exoscale-KI-Experte Christos Kapodistrias beim Pressetermin vor. In seinem Beispiel arbeiteten nicht weniger als 14 KI-Agenten orchestriert zusammen, um eine optimale Vorbereitung auf ein Kundengespräch zu erstellen. „Diesen Usecase nutzen wir auch selber“, erklärt der Experte und zeigt die verschiedenen Sicherheits- und Kontrollmechanismen ebenso wie die Nachvollziehbarkeit über die Governance-Plattform. Marco Porak merkt dazu an: „Man sieht, es gibt mehrere Checkpoints im Prozess, der ‚Human in the Loop‘ bleibt erhalten.“ Denn es gehe eben darum, Menschen bei ihrer Arbeit zu unterstützen.

Toll dass du so interessiert bist!
Hinterlasse uns bitte ein Feedback über den Button am linken Bildschirmrand.
Und klicke hier um die ganze Welt von der brutkasten zu entdecken.

brutkasten Newsletter

Aktuelle Nachrichten zu Startups, den neuesten Innovationen und politischen Entscheidungen zur Digitalisierung direkt in dein Postfach. Wähle aus unserer breiten Palette an Newslettern den passenden für dich.

Montag, Mittwoch und Freitag

AI Summaries

Diese drei Fragen sollten Investor:innen KI-Startups stellen

AI Kontextualisierung

Welche gesellschaftspolitischen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Diese drei Fragen sollten Investor:innen KI-Startups stellen

AI Kontextualisierung

Welche wirtschaftlichen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Diese drei Fragen sollten Investor:innen KI-Startups stellen

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Innovationsmanager:in?

Als Innovationsmanager:in ist es wichtig, über aktuelle Trends und Entwicklungen im Startup-Bereich informiert zu sein, um innovative Lösungen und Technologien zu identifizieren und zu nutzen. Der Artikel beschäftigt sich mit dem Thema Künstliche Intelligenz und gibt Investoren wichtige Fragen an die Hand, um die Qualität von KI-Startups zu bewerten. Diese Fragen können auch für Innovationsmanager:innen relevant sein, um potenzielle Kooperationspartner oder Lösungen im KI-Bereich genauer zu prüfen. Es geht dabei um die Unterscheidung zwischen Machine Learning und regelbasierten Systemen, den Ursprung und die Anpassung des ML-Modells sowie die Daten, mit denen das Modell trainiert wurde. Durch das Verständnis dieser Fragen können Innovationsmanager:innen sicherstellen, dass KI-Technologien in ihrer Organisation tatsächlich das halten, was sie versprechen, und eine solide Grundlage für Innovationen schaffen.

Diese drei Fragen sollten Investor:innen KI-Startups stellen

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Investor:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Diese drei Fragen sollten Investor:innen KI-Startups stellen

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Politiker:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Diese drei Fragen sollten Investor:innen KI-Startups stellen

AI Kontextualisierung

Was könnte das Bigger Picture von den Inhalten dieses Artikels sein?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Diese drei Fragen sollten Investor:innen KI-Startups stellen

AI Kontextualisierung

Wer sind die relevantesten Personen in diesem Artikel?

  • Autor: Simon Brendel

Diese drei Fragen sollten Investor:innen KI-Startups stellen

AI Kontextualisierung

Wer sind die relevantesten Organisationen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Diese drei Fragen sollten Investor:innen KI-Startups stellen