25.07.2023

Was der Data Act für österreichische Startups bedeutet

Interview. Im Juni einigten sich das EU-Parlament und die Mitgliedsstaaten auf den Data Act. Der Rechtsanwalt Arthur Stadler erklärt, was jetzt auf Startups zukommt.
/artikel/data-act-fuer-startups
Foto: Stadler Völkel Rechtsanwälte / Unsplash
Arthur Stadler erklärt, was der Data Act für österreichische Startups bedeutet. Foto: Stadler Völkel Rechtsanwälte / Unsplash

Im Wohnzimmer ist der Staubsauger-Roboter unterwegs, die Apple-Watch am Handgelenk zeichnet Gesundheitsdaten auf, das smarte Türschloss öffnet die Garageneinfahrt. Ob in den eigenen vier Wänden oder in Fabrikshallen – überall entstehen heutzutage Daten. Diese Daten haben auch einen großen wirtschaftlichen Wert, ohne sie geht in der Digital Economy nichts mehr.

Bis zu 80 Prozent der Daten ungenutzt

Ganz eigene Geschäftsmodelle wurden rund um Daten und Geräte aufgebaut: Wer etwa einen Smartwatch kauft, muss oft eine spezielle App dafür verwenden. Elektroautos werden mit ihrer eigenen Software ausgeliefert. Damit soll damit künftig jedoch Schluss sein.

Im Juni haben sich das EU-Parlament und die Mitgliedsstaaten auf den Data Act geeinigt, jetzt steht nur mehr die formelle Bestätigung aus. Der Data Act soll vor allem die Rechtssituation bei Smarten Geräten und dem Internet of Things (IoT) verbessern.

2026 soll er geltend werden und vor allem für Verbraucher:innen einiges verbessern. Aber auch für die Wirtschaft soll sich damit vieles verbessern: Die EU-Kommission erhofft sich von den neuen Regelungen ein BIP-Wachstum von 270 Millarden Euro im Wirtschaftsraum. Denn laut EU-Kommission würden derzeit bis zu 80 Prozent der Daten ungenützt bleiben.

Der Data Act im Detail

brutkasten: Was ändert der Data Act für Startups im Allgemeinen?

Arthur Stadler: Gleich vorweg: Der Data Act befindet sich noch im EU-Gesetzgebungsverfahren. Es kann also noch zu etlichen Änderungen kommen.

Die meisten wesentlichen Verpflichtungen des Data Acts gelten erst ab einer gewissen unternehmerischen Größe (grundsätzlich ab 50 Mitarbeiter und 10 Mio Euro Jahresumsatz/Jahresbilanz), sodass Startups von einem signifikanten Teil der Verpflichtungen des Data Acts grundsätzlich und realistischerweise nicht betroffen sein werden.

Startups kommen aber Rechte und Schutzmaßnahmen zugute. So werden diese etwa insbesondere vor missbräuchlichen Vertragsklauseln im Zusammenhang mit Datenzugang und Datennutzung geschützt (siehe Artikel 13 Data Act). Es soll unverbindliche Standardklauseln geben. Das stärkt die Verhandlungsposition von Startups im Zusammenhang mit der Weitergabe und Nutzung von Daten speziell gegenüber anderen Unternehmen, deren Verhandlungsmacht stärker ist und bietet neue wirtschaftliche Chancen speziell für Startups (Stichwort Datenportabilität).

Was ändert sich dadurch für die Hersteller von smarten Produkten?

Stadler: Der Data Act gilt grundsätzlich auch für Hersteller von smarten Produkten (wenn diese als Produkt im Sinne des Data Acts zu qualifizieren sind), die in der EU in Verkehr gebracht werden. Sofern gewisse Größenschwellen überschritten werden (siehe zuvor), sind diese Hersteller zu verschiedenen Vorgaben verpflichtet.

Insbesondere sind Hersteller dazu verpflichtet, Produkte so zu konzipieren und herzustellen, dass die bei der Nutzung erzeugten Daten für den Nutzer direkt zugänglich sind. Darüber hinaus bestehen vor Abschluss bestimmter Verträge für ein solches Produkt umfangreiche Informationspflichten an den Nutzer. Soweit der Nutzer nicht bereits direkt über das Produkt auf die Daten zugreifen kann, muss der Hersteller, sofern er als Dateninhaber qualifiziert wird, Zugang zu den Daten ermöglichen.

Dem Hersteller wird auch zusätzlich vorgeschrieben, nicht personenbezogene Daten nur auf Grundlage einer vertraglichen Vereinbarung mit dem Nutzer zu nutzen. Diese dürfen weiters nicht zu jedem beliebigen Zweck genützt werden. Es gibt hier spezielle Einschränkungen (vgl. Artikel 4 (6) Data Act). Darüber hinaus gibt es Regelungen zur Datenweitergabe an Dritte. So existiert das Recht des Nutzers durch die Nutzung des Produkts erzeugte Daten, die sich beim Dateninhaber befinden, einem Dritten bereitzustellen. Das führt für Hersteller smarter Produkte zu einem größeren Konkurrenzdruck, wird doch Datenportabilität vereinfacht. Dritte, die solcherart Daten erhalten, sind in der Nutzung der Daten jedoch eingeschränkt. Damit soll ein gewisses Gleichgewicht der Interessen, trotz Weitergabe von Daten, geschaffen werden.

Neu sind auch Verpflichtungen zur Bereitstellung von Daten für öffentliche Stellen wegen außergewöhnlicher Notwendigkeit. Diese Neuregelungen gelten zwar nicht für kleine Unternehmen und Kleinstunternehmen (wie etwa Startups), doch sehen sie für davon erfasste Unternehmen zusätzliche Datenbereitstellungspflichten vor.

Sieht die Regelung vor, dass alle Daten ausgelesen werden dürfen? Darf man dann z.B. einfach den Quellcode des Tesla-Autopiloten einsehen und kopieren?

Der Datenzugriff begrenzt sich auf die bei der Nutzung erzeugten Daten. Ausnahmen davon können insbesondere gegenüber öffentlichen Stellen im Falle außergewöhnlicher Notwendigkeit bestehen. Sofern man überhaupt davon ausgehen mag, dass unter „Daten“ auch ein Quellcode subsumierbar ist, würde ein auf den Quellcode bezogenes Auslesebegehren auf Basis des Data Act bereits aufgrund der Einschränkung auf die bei der Nutzung erzeugten Daten scheitern, da der Quellcode üblicherweise vorab statisch existiert und ausgeführt wird (Trennung: statischer Quellcode und dynamische/variable Nutzerdaten).

Wie gesagt, kann es sicherlich im EU-Gesetzgebungsprozess noch zu Änderungen kommen. Darüber hinaus sind Einschränkungen etwa zum Schutz von Geschäftsgeheimnissen und funktionierendem Wettbewerb zu beachten.

Werden Geschäftsgeheimnisse im Data Act ausreichend geschützt?

Der Data Act sieht zwar unterschiedliche Maßnahmen zum Schutz von Geschäftsgeheimnissen vor. Trotzdem kann eine gewisse Unsicherheit der betroffenen Unternehmen nicht gänzlich geleugnet werden.

Nachdem sich der Rechtsakt noch im Gesetzgebungsverfahren befindet, kann es hier auch noch zu Änderungen im Zusammenhang mit dem Schutz von Geschäftsgeheimnissen kommen, sodass letztlich erst die Praxis zeigen wird, wie gut der Schutz tatsächlich funktioniert. Ähnlich wie auch im Datenschutzrecht werden die Gerichte in Zweifelsfällen zu klären haben, wie weit der Schutz reicht.

Der Data Act soll laut EU-Kommission Innovationen begünstigen. Aber wofür und wie dürfen die Daten überhaupt verwendet werden?

Der leichtere Zugang zu erfassten Daten wird eine größere Auswahl an Diensten Dritter begünstigen. Diese könnten ihre Leistungen dann möglicherweise sogar preisgünstiger oder zu besserer Qualität anbieten. Davon können Startups profitieren, da diese mit den Daten arbeiten und entsprechende Leistungen anbieten werden können. So ist etwa denkbar, dass sich die Nutzer vernetzter Produkte für einen günstigeren Reparatur- und Wartungsanbieter (etwa ein Startup) entscheiden – oder sie selbst entsprechende Wartungen bzw Reparaturen durchführen. Es gelten jedoch auch hier gewisse Einschränkungen.

Was müssen Startups künftig bei der Entwicklung von smarten Produkten beachten?

Nachdem ein Wachstum eines Startups möglich ist, sollten auch die aufgrund der Größenschwellen noch nicht erfassten Startups ihre Produkte, Prozesse und Services auf den Data Act anpassen. So kann mühsamer späterer Anpassungsbedarf vermieden werden. Dementsprechend sollten Startups im Zusammenhang mit dem Data Act etwa darauf achten, Produkte bereits so zu konzipieren und herzustellen, dass bei der Nutzung erzeugte Daten für den Nutzer standardmäßig einfach, sicher und – soweit relevant und angemessen – direkt zugänglich sind.

Die neuen Regeln sollen nicht für Klein- und Kleinstunternehmen gelten. Aber für alle anderen. Welche Folgen drohen bei Nichteinhaltung?

Ähnlich wie auch im Datenschutzrecht besteht auch im Zusammenhang mit dem Data Act das Recht auf Beschwerde bei einer zuständigen Behörde. Darüber hinaus werden die Mitgliedstaaten Vorschriften zu Sanktionen bei Verstößen gegen den Data Act erlassen. Unter Umständen kommt den Aufsichtsbehörden sogar das Recht zu Geldbußen bis zu 20 Mio. Euro bzw. bis zu vier Prozent des weltweiten Gesamtjahresumsatzes des Unternehmens zu verhängen. Darüber hinaus sind auch Schadenersatzklagen denkbar.

Die Krypto-Szene befürchtet, dass mit dem Data Act ein „Kill Switch“ eingeführt wird. Was ist darunter zu verstehen und wie begründet sind diese Befürchtungen?

Im technischen Kontext kann unter einem sogenanntem „Kill Switch“ eine Art „Notaus-Funktion“ verstanden werden, die beispielsweise zu einer Unterbrechung oder zum Ausschalten einer Maschine oder dergleichen führt.

Die Befürchtungen der Krypto-Szene stützen sich vorwiegend auf den Artikel 30 des Data Acts. Dieser regelt wesentliche Anforderungen an intelligente Verträge für gemeinsame Datennutzungen und sieht für solcherart erfasste „Verträge“ etwa vor, dass es Möglichkeiten zur sicheren Beendigung und Unterbrechung geben soll. Hier sieht die Krypto-Szene teilweise Herausforderungen bei der tatsächlichen Umsetzung im Krypto-Bereich.

Auch aus unserer Sicht bedarf es noch der ein oder anderen Anpassung bzw Konkretisierung des derzeitigen Entwurfs des Data Acts. Neben den durch die Krypto-Szene monierten Aspekten sollte etwa auch sichergestellt werden, dass die Definition des intelligenten Vertrags im Artikel 2 Ziffer 16 nicht überschießend und allfällige weitere Begriffsverweisungen akkurat sind.

Bei der Verfügbarmachung von Daten sollen die sogenannten FRAND-Bedingungen gelten. Was ist das und wie hält man sich daran?

Der Begriff FRAND steht für fair, reasonable and non-dicriminatory und war bisher eher aus anderen Rechtsgebieten bekannt. Im Lichte des Data Acts versteht man sinnverwandte Umstände bzw Grundsätze auf deren Basis Datenzugang gewährt werden soll. Konkret sieht etwa Artikel 8 Absatz 1 des Data Act faire, angemessene und nichtdiskriminierende Bedingungen für die Datenbereitstellung vor. Konkretisierungen dazu finden sich etwa in Kapitel IV des Data Act.

Zusammengefasst sollte der Dateninhaber sicherstellen, dass zuvor genannte Grundsätze eingehalten und keine missbräuchlichen Klauseln verwendet werden. Die Verwendung der versprochenen Standardklauseln kann hier hilfreich sein.

Zur Person

Arthur Stadler ist Datenschutzexperte und Partner bei Stadler Völkel Rechtsanwälte.
Deine ungelesenen Artikel:
15.09.2026

Ablatic AI: Linzer LLM Talos spielt ohne VC-Kapital in einer Liga mit internationalen KI-Playern

Das nun gelaunchte Large Language Model (LLM) Talos des Linzer Startups Ablatic AI kann sich in mehreren Benchmarks mit den internationalen KI-Giganten messen. Co-Founder und CEO Florian Zimmermann erklärte uns, wie das ohne VC-Kapital möglich ist und wie man nun den Markt erobern will.
/artikel/ablatic-ai-linzer-llm-talos-spielt-ohne-vc-kapital-in-einer-liga-mit-internationalen-ki-playern
15.09.2026

Ablatic AI: Linzer LLM Talos spielt ohne VC-Kapital in einer Liga mit internationalen KI-Playern

Das nun gelaunchte Large Language Model (LLM) Talos des Linzer Startups Ablatic AI kann sich in mehreren Benchmarks mit den internationalen KI-Giganten messen. Co-Founder und CEO Florian Zimmermann erklärte uns, wie das ohne VC-Kapital möglich ist und wie man nun den Markt erobern will.
/artikel/ablatic-ai-linzer-llm-talos-spielt-ohne-vc-kapital-in-einer-liga-mit-internationalen-ki-playern
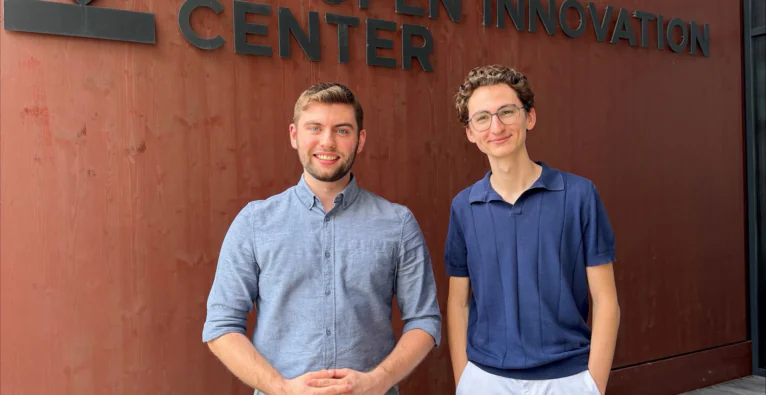
Die Ablatic-AI-Gründer vl. Florian Zimmermann (CEO) und Julian Mauerkirchner (CTO) | (c) Ablatic AI

Wieder einmal ist es Linz. Die Stahlstadt mausert sich immer mehr zu Österreichs KI-Hauptstadt und auch eines der bislang sicher ambitioniertesten Startups in dem Bereich kommt von dort: Ablatic AI. Mit Talos wagt es sich über die Herausforderung schlechthin in der KI-Welt: ein eigenes Large Language Model (LLM) – brutkasten berichtete bereits.

Bei einer Benchmark vor Sol von OpenAI

Nun erfolgte der offizielle Launch und Ablatic gab erste Benchmark-Vergleiche aus (siehe Tabelle unten). An Claude Opus 5 kommt man demnach noch in keiner Kategorie ganz heran, in mehreren aber ziemlich nahe. DeepSeek V4 kann man dagegen gleich bei drei Werten schlagen, Qwen3.8 von Alibaba bei zwei und OpenAIs Flagship-Modell GPT-5.6 Sol immerhin bei einem, konkret der exakten Befolgung schriftlicher Anweisungen (IFBench). Unterm Strich spielt das Linzer LLM also in den vorgelegten Benchmarks in der internationalen Top-Liga mit.

„Es kann ja nicht sein, dass es in Europa nur Mistral gibt“

Aber warum überhaupt noch ein weiteres LLM? „Julian [Anm. Mauerkirchner] und ich kennen uns schon seit der Schule. Später haben wir als Unternehmer damit gestartet, Legacy-ERP-Systeme zu erneuern. Dabei sind wir auf ein Problem gestoßen: Wir konnten dafür aus Daten-Gründen keine US-KI-Systeme nutzen“, erzählt CEO Florian Zimmermann, der Ablatic AI gemeinsam mit Julian Mauerkirchner (CTO) gegründet hat, im Gespräch mit brutkasten. Man habe nur Mistral aus Frankreich oder Open-Source-Modelle verwenden können. „Mistral war für den Zweck aber nicht passend und unser Business Case bald tot“.

Mit dem Entschluss, eine neue Idee zu verfolgen, sei daher auch eine neue Motivation einher gegangen: „Es kann ja nicht sein, dass es in Europa nur Mistral gibt“, so Zimmermann. Man habe sich danach mit der Johannes Kepler Universität Linz (JKU) kurzgeschlossen und sei darüber auch zur AI Factory Austria AI:AT gekommen, wo man wiederum im Rahmen des EuroHPC-Programms europäische Hochleistungsrechenressourcen nutzt, um das Modell zu trainieren. „Ohne diese EU-Ressourcen würde es kostentechnisch überhaupt nicht gehen“, sagt Zimmermann.

Öffentliche Forschungsergebnisse statt eigenes Riesen-Research-Team

Doch auch mit diesen Ressourcen – wie lässt sich ein konkurrenzfähiges LLM mit einem kleinen Team und bislang gänzlich ohne VC-Kapital umsetzen? Schließlich beschäftigen die globalen KI-Player, mit denen sich Ablatic misst, riesige Teams. Mistral etwa ist mit seiner kürzlich kommuniziert Drei-Milliarden-Euro-Finanzierungsrunde im Vergleich zu Anthropic und OpenAI nach wie vor ein kleiner Fisch (brutkasten analysierte).

„Wir können kein 200-köpfiges Research-Team finanzieren und gleich von 0 auf 100 gehen, also greifen wir auf Bestehendes zurück“, erklärt der Gründer. Konkret verwende man einerseits Open-Source-Layer und code sie auf die eigenen Bedürfnisse um. Andererseits nutze man die neuesten Forschungsergebnisse von Universitäten wie dem MIT oder Stanford, die laufend über die Plattform arXiv veröffentlicht werden. „Wir orientieren uns an der Frontier-Forschung. Wir analysieren die Paper, legen die Erkenntnisse auf unsere Architektur um und testen es durch. Vieles davon funktioniert nicht, aber alles was funktioniert, bringt uns weiter“, so Zimmermann.

Mehr als 100 B2B-Testkunden – viele konvertieren gleich zum Launch

Die Beta-Version wurde nun bereits seit einiger Zeit mit mehr als 100 Unternehmen getestet – Ablatic konzentriert sich nämlich vorerst klar auf den B2B-Markt. Man habe für diese Tests schnell auch größere Unternehmen und Konzerne gewonnen. „Ich bin dafür wochenlang gesessen, habe Leute angeschrieben und einen Call nach dem anderen gemacht“, räumt Zimmermann ein. Dass man ein eigenes LLM und nicht nur eine Oberfläche baue, sei dabei zum entscheidenden Bonus geworden. „Und dass wir von der JKU kommen und im EuroHPC-Programm sind, hat unsere Glaubwürdigkeit enorm gesteigert“, sagt der Gründer.

Jetzt zum Launch würden viele der Testkunden bereits zu regulären Nutzern konvertieren, viele weitere noch die Testphase abschließen, mit dem Vorhaben, das dann auch zu tun, verrät Zimmermann. „Wir werden nicht 100 Prozent, aber einen Großteil konvertieren können“, ist er sicher. Punkten will Ablatic dabei nicht nur mit der europäischen Herkunft – Stichwort: Digitale Souveränität – sondern auch mit dem Pricing. „Wir haben eine relativ effiziente Architektur. Wir können kostengünstig hosten und das an die Kunden weitergeben“, so der CEO. Dass der offizielle Launch genau jetzt erfolgt, hat vor allem mit dem Gründungsprozess zu tun, der länger dauerte, als erhofft. „Ich gründe nie wieder im Sommer ein Unternehmen“, sagt der Gründer lachend.

Investment geplant: „Das Ziel ist definitiv, keine kleine Bude zu bleiben“

Und wie geht es weiter? „Wir wollen zuerst im DACH-Raum Fuß fassen und ohne große weitere Standorte skalieren. Dann wollen wir es auf Europa hochziehen“, erläutert Zimmermann. Auf Dauer werde dabei auch die Aufnahme von VC-Kapital relevant, vor allem wenn es darum gehe, die nächste Modell-Version herauszubringen. „Dann ist es wichtig, dass man schnell skaliert und iteriert. Wir sind stolz darauf, dass wir ein Modell ohne VC-Kapital trainiert haben. Wir haben gezeigt, dass auch so Großes möglich ist. Aber langfristig ist es völlig logisch, dass wir Kapital aufnehmen müssen“, sagt der Gründer.

Und es seien bereits mehrere Investoren aktiv auf das Team zugekommen, mit einigen befinde man sich schon in Gesprächen. „Das Ziel ist definitiv, keine kleine Bude zu bleiben, sondern eine größere Firma zu werden. Wir wollen jedenfalls nicht in Vergessenheit geraten“, so Zimmermann. Und der Zeitpunkt sei angesichts der Souveränitätsdebatte gut.


Benchmark-Vergleichstabelle

Anmerkungen zur Tabelle:

  • Fette Zahlen: Höchster Wert in der jeweiligen Zeile unter den Vergleichsmodellen.
  • „text-only“: Das Modell verarbeitet keine Bilder/visuellen Dokumente, weshalb OmniDocBench nicht anwendbar ist.
  • „–“: Kein veröffentlichter Wert vorhanden.

Kurzerklärungen der Benchmarks

  • Agents‘ Last Exam (UC Berkeley): Prüft langwierige, echte Arbeitsaufgaben an einem Computer (Terminal und Bildschirm zusammen), bewertet anhand des fertigen Gesamtergebnisses.
  • AutomationBench (Zapier): Testet 600 Business-Workflows über 47 simulierte Unternehmens-Softwaretools hinweg, die vollständig durchgehend ausgeführt werden müssen.
  • Toolathlon: Bewertet das Erledigen von Aufgaben in echter Büro-Software (z. B. E-Mail, Kalender, Tabellenkalkulationen und GitHub) über deren direkte Schnittstellen.
  • BrowseComp (OpenAI): Stellt schwierige Fragen, deren Antworten über das gesamte Internet verstreut liegen und durch selbstständiges Surfen recherchiert werden müssen.
  • DeepSWE v1.1 (Datacurve): Misst das eigenständige Beheben echter Softwareprobleme (Bugs) in bestehenden Quellcode-Sammlungen. Hinweis: Talos-1 wurde hierfür nicht optimiert und liegt 22 Punkte hinter der Spitze zurück.
  • OmniDocBench: Bewertet das fehlerfreie Lesen und Verstehen echter Dokumente inklusive visueller Layouts, Tabellen und mathematischer Formeln.
  • IFBench: Prüft die exakte Einhaltung von schriftlich vorgegebenen Anweisungen und Formatierungsregeln.
Toll dass du so interessiert bist!
Hinterlasse uns bitte ein Feedback über den Button am linken Bildschirmrand.
Und klicke hier um die ganze Welt von der brutkasten zu entdecken.

brutkasten Newsletter

Aktuelle Nachrichten zu Startups, den neuesten Innovationen und politischen Entscheidungen zur Digitalisierung direkt in dein Postfach. Wähle aus unserer breiten Palette an Newslettern den passenden für dich.

Montag, Mittwoch und Freitag

AI Summaries

Was der Data Act für österreichische Startups bedeutet

AI Kontextualisierung

Welche gesellschaftspolitischen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was der Data Act für österreichische Startups bedeutet

AI Kontextualisierung

Welche wirtschaftlichen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was der Data Act für österreichische Startups bedeutet

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Innovationsmanager:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was der Data Act für österreichische Startups bedeutet

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Investor:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was der Data Act für österreichische Startups bedeutet

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Politiker:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was der Data Act für österreichische Startups bedeutet

AI Kontextualisierung

Was könnte das Bigger Picture von den Inhalten dieses Artikels sein?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was der Data Act für österreichische Startups bedeutet

AI Kontextualisierung

Wer sind die relevantesten Personen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was der Data Act für österreichische Startups bedeutet

AI Kontextualisierung

Wer sind die relevantesten Organisationen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was der Data Act für österreichische Startups bedeutet