15.07.2019

Was macht eigentlich ein Data Scientist?

Das Buzzword "Data Science" geistert derzeit durch die Innovationsabteilungen quer über alle Branchen hinweg. Der Job-Titel "Data Scientist" ist einer der häufigsten in einschlägigen Karriere-Plattformen. Doch worum geht es dabei eigentlich? Wir haben mit drei sehr unterschiedlichen Data Scientists gesprochen.
/artikel/was-macht-ein-data-scientist
Was macht eigentlich ein Data Scientist? Wir haben das Sclable-Data Science-Team gefragt
(c) Tobias Fittner: Das Sclable-AI- und Data Science-Team (vlnr.): Sanchit Singh, Ronald Luc, Frank Fichtenmüller, Charles Dietz und Viktor Sandner

„Data Science bezeichnet generell die Extraktion von Wissen aus Daten“ – so lautet die verkürzte Definition auf Wikipedia. Daraus lässt sich eines bereits klar ableiten: Der Beruf „Data Scientist“ lässt sich nicht auf einzelne spezifische Tätigkeiten eingrenzen. Tatsächlich bietet der Job, der auf einschlägigen Karriere-Plattformen von Unternehmen jeder Größe derzeit stark nachgefragt wird, einen großen Spielraum. Dabei sind ganz unterschiedliche Kompetenzen vonnöten.

+++ Mehr zum Thema Human Ressources +++

„Lauter offene Münder“

Ein Unternehmen, bei dem Data Science zum Kerngeschäft gehört, ist der Business Accelerator Sclable mit Hauptsitz im Wiener weXelerate. Dort unterstützt man seit sieben Jahren Kunden aus der nationalen und internationalen traditionellen Industrie wie Umdasch Group Ventures und ihr Schwesterunternehmen Doka oder Palfinger in Sachen digitale Transformation. Ein entscheidender Faktor ist dabei die Nutzung von Daten, um Prozesse effizienter zu machen. „Du löst dabei etwas, das für dich eine absolute ‚low hanging fruit‘ ist. Aber beim Kunden siehst du bei der Präsentation der Ergebnisse lauter offene Münder“, sagt Viktor Sandner, Head of Data Science and Methodology bei Sclable.

„Es gibt keinen Data Science Fullstack Developer“

Die Nische Finden

Sandner kommt eigentlich aus dem Biotech-Bereich. „Ich bin in meiner Forschung mit Excel-Tabellen bald an meine Grenzen gestoßen. Ich habe daher programmieren gelernt und es hat sich plötzlich eine ganze neue Welt offenbart“, erzählt er. So habe er begonnen, nach Daten-Lösungen für die gesamte Branche zu suchen und sei damit zum „Experten mit einem gewissen Extra“ geworden – konkret im Bereich Statistik. Denn eines müsse man im breiten Feld der Data Science finden, um zu reüssieren: Eine Nische.

Diverses Data Science-Team

„Es gibt keinen Data Science Fullstack Developer“, sagt auch Sandners Kollege Ronald Luc, Machine Learning Engineer bei Sclable, und ebenfalls ein „Data Scientist“. Man brauche ein diverses Team. Während sich Viktor Sandner mit statistischen Methoden auf die Suche nach teilweise versteckten Korrelationen in großen Datensets macht, ist Lucs Domäne die Vorhersage von Werten mit Hilfe von Deep Learning – teilweise auf Basis von durch seinen Kollegen aufbereiteten Daten. „Manchmal sind aber gar keine Daten vorhanden. Dann erstelle ich mit Hilfe von detaillierten Interviews ein mathematisches Modell zur Vorhersage“, erklärt Luc.

Es braucht nicht immer Deep Learning

Ein weiteres Feld der Data Science deckt bei Sclable Sanchit Singh ab. Der Head of Computer Vision beschäftigt sich mit der Analyse von zwei- und dreidimensionalen Bild-Inhalten. Auch er arbeitet mit Deep Learning – das sei aber nicht zwingend notwendig. „Es lässt sich vieles mit dem klassischen Computer Vision-Ansatz machen, wo auf Basis von mathematischen Modellen Vergleiche durchgeführt werden und Klassifikationen erstellt werden können“, erklärt Singh. Als Beispiel nennt er, der ursprünglich aus dem Medizin-Bereich kommt, die Hautkrebs-Forschung. Dort könnten Bilder von Haut-Anomalien etwa nach dem Abgleich der Parameter Farbe, Form und Symmetrie sehr treffsicher kategorisiert werden. „Das kann z.B. einem Allgemeinmediziner helfen, der selten mit der Krankheit konfrontiert ist, eine erste Verdachtsdiagnose zu stellen“, sagt der Computer Vision-Experte.

Das unvoreingenommene Programm

Deep Learning bringe aber freilich weitere Möglichkeiten. Hier bestünden zwei Ansätze: „Supervised Learning“ und „Unsupervised Learning“. „Während ich beim ‚Supervised Learning‘ gewisse Informationen einfüttere – in unserem Beispiel etwa die bereits als Hautkrebs klassifizierte Bilder, die dem Programm als Grundlage dienen, ist es beim ‚Unsupervised Learning‘ quasi unvoreingenommen und bildet selbstständig Cluster“, erklärt Singh. Dieser Zugang könne unerwartete Zusammenhänge und damit neue Erkenntnisse ans Tageslicht bringen.

Big Data als Fluch und Segen

Voraussetzung für das Gelingen sei gerade beim „Unsupervised Learning“, aber auch in den anderen „Data Science“-Bereichen, das Vorhandensein ausreichender Datenmengen. Und diese können sich für Data Scientists als Fluch und Segen zugleich erweisen. „Wir sprechen hier von Big Data. Je nachdem, um was für Daten es sich handelt, können Datensets aber auch zu groß werden, um sie bearbeiten zu können. Gerade bei Bildern und Videos ist man sehr schnell im Terrabyte-Bereich und muss dann gegebenenfalls ein kleineres Datenset heranziehen oder an großen Computing-Clustern arbeiten“, erklärt Ronald Luc.

Data Scientist – „ein Blick“ für Daten

Und das ist nicht die einzige Herausforderung, mit der man als Data Scientist konfrontiert ist. „Kunden haben häufig zwar große Mengen an Daten, wissen aber gar nicht, was sie damit anfangen können und können daher auch keine Ziele für die Analyse definieren“, erzählt Viktor Sandner. In anderen Fällen würden die Ziele nicht mit den verfügbaren Daten zusammenpassen. „Das kann man aber sehr schnell herausfinden. Nach einiger Zeit hat man einen Blick dafür und sieht sofort, ob das Unterfangen erfolgsversprechend ist“.

„Ich lese jeden Tag zum Frühstück ein Paper“

Ausruhen könne man sich darauf aber nicht. Denn die rapide Entwicklung in dem Bereich erfordere ständige Anpassung. „Die gesamte Technologie, die wir verwenden, ändert sich alle paar Monate“, sagt Sanchit Singh. Für Ronald Luc ergibt sich dadurch eine besondere Morgen-Routine: „Ich lese jeden Tag zum Frühstück ein Paper“.
Redaktionstipps
Deine ungelesenen Artikel:
09.11.2026

Patent oder Geheimhaltung? Wie das Wiener ClimateTech-Startup sequestra seine IP schützt

Einzigartige Technologie braucht Schutz, um am internationalen Markt zu bestehen. Das gilt vor allem, wenn sie von einem Startup kommt, das noch keine Marktmacht hat. Wir sprachen mit Lukas Höber, Co-Founder und CEO des Wiener Startups sequestra, darüber, wie die Austria Wirtschaftsservice (aws) das Unternehmen im Innovationsschutz unterstützt und warum in manchen Fällen Geheimhaltung der bessere Weg als ein Patent ist.
/artikel/patent-oder-geheimhaltung-wie-das-wiener-climatetech-startup-sequestra-seine-ip-schuetzt
09.11.2026

Patent oder Geheimhaltung? Wie das Wiener ClimateTech-Startup sequestra seine IP schützt

Einzigartige Technologie braucht Schutz, um am internationalen Markt zu bestehen. Das gilt vor allem, wenn sie von einem Startup kommt, das noch keine Marktmacht hat. Wir sprachen mit Lukas Höber, Co-Founder und CEO des Wiener Startups sequestra, darüber, wie die Austria Wirtschaftsservice (aws) das Unternehmen im Innovationsschutz unterstützt und warum in manchen Fällen Geheimhaltung der bessere Weg als ein Patent ist.
/artikel/patent-oder-geheimhaltung-wie-das-wiener-climatetech-startup-sequestra-seine-ip-schuetzt
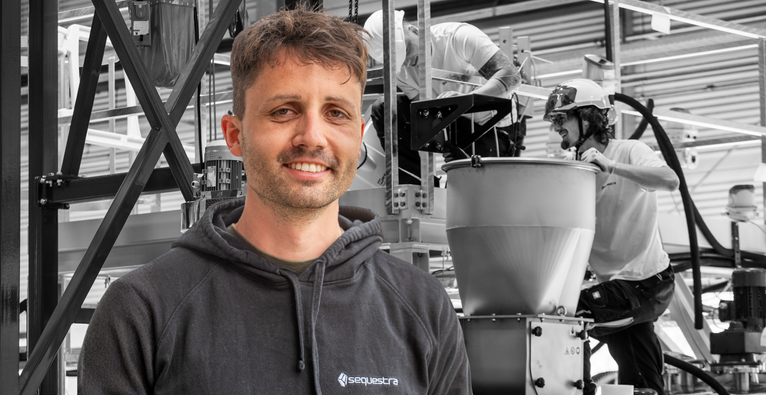
Lukas Höber ist Co-Founder und CEO von sequestra | (c) sequestra

Auch wenn die Debatte rund um den Klimawandel bekanntlich nicht geradlinig verläuft: Industrieunternehmen auf der ganzen Welt haben sich teils mehr, teils weniger ambitionierte Ziele in der CO2-Reduktion gesetzt. Die Emission des Treibhausgases kann aber nicht in allen Industrien tatsächlich vermieden werden. Überall, wo der CO2-Ausstoß unweigerlich zum Prozess dazugehört, braucht es andere Lösungen. An einer davon arbeitet das Wiener Startup sequestra – brutkasten berichtete bereits mehrmals.

CO2-Abbindung trifft Recycling

„Wir entwickeln Technologien, mit denen man CO2 stabil in mineralischen Reststoffen oder auch Primärmaterialien abbinden kann“, erklärt Co-Founder und CEO Lukas Höber im Gespräch mit brutkasten. Dabei setzt sequestra auf Abfallprodukte, etwa Schlacken, Aschen, Bauschutt oder Bergbauabfälle. „Die enthalten oft mineralische Verbindungen, die CO2 stabil abbinden können. Das sind vor allem Calcium- und Magnesiumverbindungen“, so der Gründer. Diese Stoffe nutzt sequestra in seinen Reaktoren. Das nach dem Prozess verbleibende Material soll dann nicht einfach deponiert, sondern zurück in den Kreislauf geführt werden, etwa im Straßenbau oder der Betonindustrie.

Weltweit einzigartiges Labor bereits im Einsatz

Das ist der Plan. Denn noch stehen keine sequestra-Anlagen bei Industriekunden – so weit will man Ende 2027 sein. Schon jetzt betreibt das Startup allerdings ein weltweit einzigartiges Labor, in dem Stoffe auf die Nutzbarkeit zur CO2-Abbindung untersucht werden können – brutkasten berichtete. „Firmen aus der ganzen Welt schicken uns bereits ihr Material und wir prüfen es“, sagt Höber.

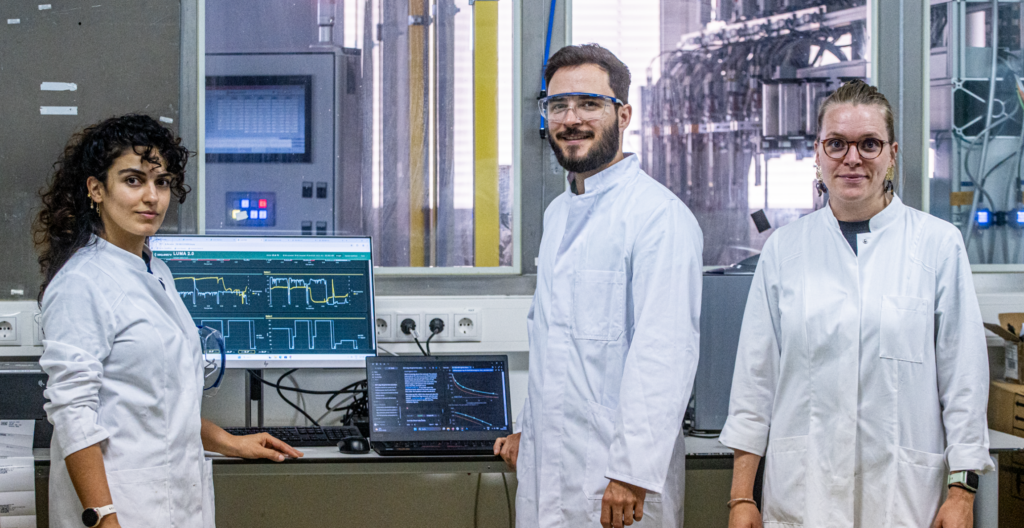
Das Labor von sequestra ist weltweit einzigartig. | © sequestra

Patentschutz mit Unterstützung der Austria Wirtschaftsservice (aws)

Die technologischen Prozesse, die sequestra für all das nutzt, sind komplex. Und sie sind weltweit einzigartig. Gleichzeitig forschen Mitbewerber auf der ganzen Welt an derartigen Lösungen. Der Schutz der IP durch Patente liegt also auf der Hand. „Wir haben bislang drei Patente angemeldet, bei einem vierten sind wir momentan im Prozess“, erzählt Höber. Dabei wird sequestra auch von der Austria Wirtschaftsservice (aws) unterstützt.

Konkret nutzte das Startup zum einen die Förderung der Austria Wirtschaftsservice (aws) „Freedom to Operate“. „Man muss auch bei den eigenen Prozessen wissen, was man machen darf. Wenn ein einzelner Prozessschritt bereits von jemand anderem patentiert ist, hat man ein Problem. Daher müssen Patentanwälte ermitteln, was noch frei ist“, erklärt Höber.

Zum anderen nationalisiert sequestra gerade zwei seiner bestehenden Patente, eines davon in den USA, Kanada und im Vereinigten Königreich, denn im ersten Schritt galten diese nur innerhalb der EU. „Hier fördert uns die Austria Wirtschaftsservice (aws) im Rahmen des Programms aws Innovationsschutz mit 50 Prozent“, sagt der Gründer. „Das ist ein extrem kostspieliger Prozess, die Förderung hilft uns also sehr.“

„In manchen Fällen ist es auch schlauer, etwas nicht patentieren zu lassen“

Ist es damit mit dem Schutz der Technologie getan? „Patente sind für uns sehr wichtig, manche komplexen Prozessabläufe kann man aber gar nicht patentieren und in manchen Fällen ist es auch schlauer, etwas nicht patentieren zu lassen“, erklärt Höber. Denn nicht nur sei die Patentierung ein teurer und sehr zeitaufwändiger Vorgang. „Sobald etwas patentiert ist, ist es öffentlich für alle auf der Welt einsehbar und in manchen Ländern kann der Patentschutz umgangen werden“, so der Gründer.

Die Lösung für diese Fälle? Geheimhaltung. Tatsächlich habe man aktuell nur rund 20 Prozent der eigenen Technologie patentiert, der Rest seien Betriebsgeheimnisse. „Als schnell wachsendes Tech-Unternehmen kann man es gar nicht anders machen“, ist Höber überzeugt. Er gibt ein internationales Beispiel: „SpaceX praktiziert das enorm. Trotz der Größe hat das Unternehmen nur ca. 500 Patente. Der Rest läuft über Geschäftsgeheimnisse, um schnell zu sein.“

Rasante Weiterentwicklung – technologisch und am Markt

Und diese Geschwindigkeit brauche man, denn die technologische Entwicklung geht auch bei sequestra zügig weiter. Ein aktuelles Forschungsprojekt, das auch von der FFG gefördert wird, soll etwa die Einsatzmöglichkeit der Technologie auf ein anderes Level heben. „Im Moment brauchen wir für unsere Reaktoren noch hochreine CO2-Ströme, die nur in bestimmten Verfahren entstehen, etwa in Biogas-Anlagen. Mit diesem Entwicklungsschritt wollen wir auch Abgase verarbeiten können, die einen weit geringeren CO2-Anteil haben“, sagt der Gründer.

Und nicht nur technologisch entwickelt sich das Startup rasant weiter, wie Höber, den wir per Videocall auf einer Konferenz in Südafrika erreichen, erzählt: „Ich spreche hier unter anderem mit Bergbauunternehmen. Danach geht es für mich weiter nach Südostasien. Das Potenzial ist enorm und die Nachfrage nicht nur in Europa hoch.“


Disclaimer: Dieser Artikel ist im Rahmen einer Medienbeauftragung mit der Austria Wirtschaftsservice (aws) entstanden.

Toll dass du so interessiert bist!
Hinterlasse uns bitte ein Feedback über den Button am linken Bildschirmrand.
Und klicke hier um die ganze Welt von der brutkasten zu entdecken.

brutkasten Newsletter

Aktuelle Nachrichten zu Startups, den neuesten Innovationen und politischen Entscheidungen zur Digitalisierung direkt in dein Postfach. Wähle aus unserer breiten Palette an Newslettern den passenden für dich.

Montag, Mittwoch und Freitag

AI Summaries

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Welche gesellschaftspolitischen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Welche wirtschaftlichen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Innovationsmanager:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Investor:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Politiker:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Was könnte das Bigger Picture von den Inhalten dieses Artikels sein?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Wer sind die relevantesten Personen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Wer sind die relevantesten Organisationen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?