
15.07.2019

Was macht eigentlich ein Data Scientist?

Das Buzzword "Data Science" geistert derzeit durch die Innovationsabteilungen quer über alle Branchen hinweg. Der Job-Titel "Data Scientist" ist einer der häufigsten in einschlägigen Karriere-Plattformen. Doch worum geht es dabei eigentlich? Wir haben mit drei sehr unterschiedlichen Data Scientists gesprochen.
/artikel/was-macht-ein-data-scientist
Was macht eigentlich ein Data Scientist? Wir haben das Sclable-Data Science-Team gefragt
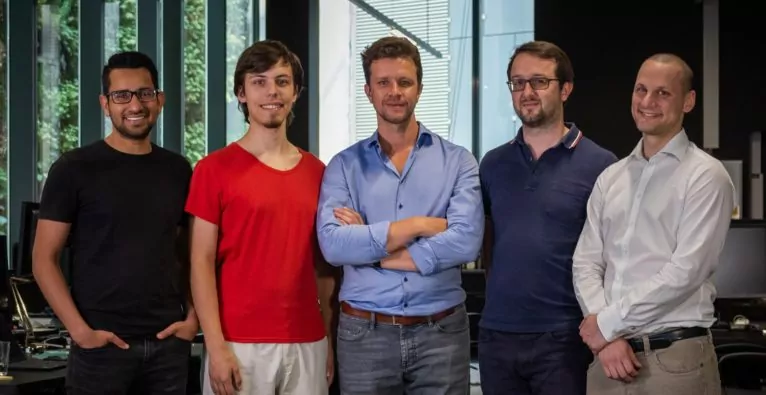
(c) Tobias Fittner: Das Sclable-AI- und Data Science-Team (vlnr.): Sanchit Singh, Ronald Luc, Frank Fichtenmüller, Charles Dietz und Viktor Sandner

„Data Science bezeichnet generell die Extraktion von Wissen aus Daten“ – so lautet die verkürzte Definition auf Wikipedia. Daraus lässt sich eines bereits klar ableiten: Der Beruf „Data Scientist“ lässt sich nicht auf einzelne spezifische Tätigkeiten eingrenzen. Tatsächlich bietet der Job, der auf einschlägigen Karriere-Plattformen von Unternehmen jeder Größe derzeit stark nachgefragt wird, einen großen Spielraum. Dabei sind ganz unterschiedliche Kompetenzen vonnöten.

+++ Mehr zum Thema Human Ressources +++

„Lauter offene Münder“

Ein Unternehmen, bei dem Data Science zum Kerngeschäft gehört, ist der Business Accelerator Sclable mit Hauptsitz im Wiener weXelerate. Dort unterstützt man seit sieben Jahren Kunden aus der nationalen und internationalen traditionellen Industrie wie Umdasch Group Ventures und ihr Schwesterunternehmen Doka oder Palfinger in Sachen digitale Transformation. Ein entscheidender Faktor ist dabei die Nutzung von Daten, um Prozesse effizienter zu machen. „Du löst dabei etwas, das für dich eine absolute ‚low hanging fruit‘ ist. Aber beim Kunden siehst du bei der Präsentation der Ergebnisse lauter offene Münder“, sagt Viktor Sandner, Head of Data Science and Methodology bei Sclable.

„Es gibt keinen Data Science Fullstack Developer“

Die Nische Finden

Sandner kommt eigentlich aus dem Biotech-Bereich. „Ich bin in meiner Forschung mit Excel-Tabellen bald an meine Grenzen gestoßen. Ich habe daher programmieren gelernt und es hat sich plötzlich eine ganze neue Welt offenbart“, erzählt er. So habe er begonnen, nach Daten-Lösungen für die gesamte Branche zu suchen und sei damit zum „Experten mit einem gewissen Extra“ geworden – konkret im Bereich Statistik. Denn eines müsse man im breiten Feld der Data Science finden, um zu reüssieren: Eine Nische.

Diverses Data Science-Team

„Es gibt keinen Data Science Fullstack Developer“, sagt auch Sandners Kollege Ronald Luc, Machine Learning Engineer bei Sclable, und ebenfalls ein „Data Scientist“. Man brauche ein diverses Team. Während sich Viktor Sandner mit statistischen Methoden auf die Suche nach teilweise versteckten Korrelationen in großen Datensets macht, ist Lucs Domäne die Vorhersage von Werten mit Hilfe von Deep Learning – teilweise auf Basis von durch seinen Kollegen aufbereiteten Daten. „Manchmal sind aber gar keine Daten vorhanden. Dann erstelle ich mit Hilfe von detaillierten Interviews ein mathematisches Modell zur Vorhersage“, erklärt Luc.

Es braucht nicht immer Deep Learning

Ein weiteres Feld der Data Science deckt bei Sclable Sanchit Singh ab. Der Head of Computer Vision beschäftigt sich mit der Analyse von zwei- und dreidimensionalen Bild-Inhalten. Auch er arbeitet mit Deep Learning – das sei aber nicht zwingend notwendig. „Es lässt sich vieles mit dem klassischen Computer Vision-Ansatz machen, wo auf Basis von mathematischen Modellen Vergleiche durchgeführt werden und Klassifikationen erstellt werden können“, erklärt Singh. Als Beispiel nennt er, der ursprünglich aus dem Medizin-Bereich kommt, die Hautkrebs-Forschung. Dort könnten Bilder von Haut-Anomalien etwa nach dem Abgleich der Parameter Farbe, Form und Symmetrie sehr treffsicher kategorisiert werden. „Das kann z.B. einem Allgemeinmediziner helfen, der selten mit der Krankheit konfrontiert ist, eine erste Verdachtsdiagnose zu stellen“, sagt der Computer Vision-Experte.

Das unvoreingenommene Programm

Deep Learning bringe aber freilich weitere Möglichkeiten. Hier bestünden zwei Ansätze: „Supervised Learning“ und „Unsupervised Learning“. „Während ich beim ‚Supervised Learning‘ gewisse Informationen einfüttere – in unserem Beispiel etwa die bereits als Hautkrebs klassifizierte Bilder, die dem Programm als Grundlage dienen, ist es beim ‚Unsupervised Learning‘ quasi unvoreingenommen und bildet selbstständig Cluster“, erklärt Singh. Dieser Zugang könne unerwartete Zusammenhänge und damit neue Erkenntnisse ans Tageslicht bringen.

Big Data als Fluch und Segen

Voraussetzung für das Gelingen sei gerade beim „Unsupervised Learning“, aber auch in den anderen „Data Science“-Bereichen, das Vorhandensein ausreichender Datenmengen. Und diese können sich für Data Scientists als Fluch und Segen zugleich erweisen. „Wir sprechen hier von Big Data. Je nachdem, um was für Daten es sich handelt, können Datensets aber auch zu groß werden, um sie bearbeiten zu können. Gerade bei Bildern und Videos ist man sehr schnell im Terrabyte-Bereich und muss dann gegebenenfalls ein kleineres Datenset heranziehen oder an großen Computing-Clustern arbeiten“, erklärt Ronald Luc.

Data Scientist – „ein Blick“ für Daten

Und das ist nicht die einzige Herausforderung, mit der man als Data Scientist konfrontiert ist. „Kunden haben häufig zwar große Mengen an Daten, wissen aber gar nicht, was sie damit anfangen können und können daher auch keine Ziele für die Analyse definieren“, erzählt Viktor Sandner. In anderen Fällen würden die Ziele nicht mit den verfügbaren Daten zusammenpassen. „Das kann man aber sehr schnell herausfinden. Nach einiger Zeit hat man einen Blick dafür und sieht sofort, ob das Unterfangen erfolgsversprechend ist“.

„Ich lese jeden Tag zum Frühstück ein Paper“

Ausruhen könne man sich darauf aber nicht. Denn die rapide Entwicklung in dem Bereich erfordere ständige Anpassung. „Die gesamte Technologie, die wir verwenden, ändert sich alle paar Monate“, sagt Sanchit Singh. Für Ronald Luc ergibt sich dadurch eine besondere Morgen-Routine: „Ich lese jeden Tag zum Frühstück ein Paper“.
Redaktionstipps
Deine ungelesenen Artikel:
12.11.2026

530 Mio. US-Dollar: Investments für zwei Münchner Startups

Agile Robots holt sich 500 Millionen US-Dollar Kapital. Währenddessen schließt das Deeptech-Startup SE3 eine Finanzierungsrunde von 30 Millionen US-Dollar ab.
/artikel/530-mio-us-dollar-investments-fuer-zwei-muenchner-startups
12.11.2026

530 Mio. US-Dollar: Investments für zwei Münchner Startups

Agile Robots holt sich 500 Millionen US-Dollar Kapital. Währenddessen schließt das Deeptech-Startup SE3 eine Finanzierungsrunde von 30 Millionen US-Dollar ab.
/artikel/530-mio-us-dollar-investments-fuer-zwei-muenchner-startups
Links Agile-Robots-CEO Zhaopeng Chen mit einem Humanoiden und rechts die SE3-Technologie im Einsatz | (c) Agile Robotics / SE3 / Canva

„Unsere Vision ist, dass intelligente Roboter überall auf der Welt in Fabriken und Lagern mit Menschen zusammenarbeiten“, mit diesen Worten verkündet Zhaopeng Chen, Gründer und CEO von Agile Robots, eine Finanzierungsrunde von 500 Millionen US-Dollar. Angeführt wurde die Serie-F-Runde von der SoftBank Group. Weitere Investoren kommen aus der Automobilindustrie, der künstlichen Intelligenz sowie der Digital- und Industrietechnologie, darunter etwa Nvidia, die Hitachi Group und T.Capital. Insgesamt steigt das eingeworbene Kapital des Münchner Scaleups auf zwei Milliarden US-Dollar. Die Bewertung des Unternehmens beträgt nun 8,5 Milliarden US-Dollar.

Kapital für internationales Wachstum

„Wir bringen Physical AI aus dem Labor in die Industrie, sei es in der Logistik, der Automobil- und Elektronikbranche oder der Fertigung. Mit der neuen Finanzierung können wir schneller international wachsen, unsere Präsenz in wichtigen Märkten ausbauen und unsere Produktionskapazitäten erweitern“, sagt Chen. Man wolle vor allem seine Präsenz in den USA stärken und die Entwicklung neuer Robotikanwendungen beschleunigen.

Agile Robots entwickelt humanoide und mobile Roboter, Roboterarme und -hände sowie die Software und KI-Modelle, die sie steuern. Dadurch können Industrieunternehmen auch Aufgaben automatisieren, für die bisher menschliches Fingerspitzengefühl und Urteilsvermögen nötig waren. 

30 Millionen US-Dollar für Europas Verteidigung

Ebenfalls eine Finanzierungsrunde in Millionenhöhe, wenn auch nicht in der Größenordnung von Agile Robots, sicherte sich das Münchner Startup SE3. In einer Serie-A-Finanzierungsrunde lukrierte die Deeptech-Firma 30 Millionen US-Dollar. Accel führte die Runde an, mit Beteiligung von Keen, Lakestar und Seedcamp.

„Die Finanzierung dient dem Ausbau der Entwicklungs-, Vertriebs- und Betriebsteams von SE3, um für die Erfüllung weiterer Aufträge im Zuge des Unternehmenswachstums gerüstet zu sein“, schreibt das Unternehmen auf seiner Webseite. Neben der Stärkung der Präsenz in Deutschland und der Ukraine eröffnet SE3 auch ein Büro in Großbritannien und plant die weitere Expansion in Europa.

Das Münchner Unternehmen arbeitet daran, Sensordaten in räumliches Verständnis umzuwandeln, sodass Maschinen autonom arbeiten können. SE3 entwickelt seine Technologie für komplexe Umgebungen, in denen Systeme zuverlässig funktionieren müssen, auch bei Störungen der Satellitennavigation. Das Startup konzentriert sich primär auf die europäische Verteidigung. Dieser Sektor bleibt vorerst der Schwerpunkt. Ab 2027 sollen Robotik, Katastrophenschutz und andere zivile Anwendungen für anspruchsvolle Umgebungen erforscht werden.

Toll dass du so interessiert bist!
Hinterlasse uns bitte ein Feedback über den Button am linken Bildschirmrand.
Und klicke hier um die ganze Welt von der brutkasten zu entdecken.

brutkasten Newsletter

Aktuelle Nachrichten zu Startups, den neuesten Innovationen und politischen Entscheidungen zur Digitalisierung direkt in dein Postfach. Wähle aus unserer breiten Palette an Newslettern den passenden für dich.

Montag, Mittwoch und Freitag

AI Summaries

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Welche gesellschaftspolitischen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Welche wirtschaftlichen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Innovationsmanager:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Investor:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Politiker:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Was könnte das Bigger Picture von den Inhalten dieses Artikels sein?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Wer sind die relevantesten Personen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Wer sind die relevantesten Organisationen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?