SAP hat auf seiner jährlichen Entwicklerkonferenz „SAP TechEd“ Ende Oktober eine Reihe von KI-Innovationen bekannt gegeben, die das SAP-Portfolio für Entwickler erweitern. Erweiterungen der Joule-Lösungen und der SAP Business AI Platform – einschließlich des neuesten Foundation Models von SAP für tabellarische Daten – sollen neue Tools zur Entwicklung und Erweiterung von KI-Agenten bereitstellen. Zugleich sollen sie den Agenten Daten- und Geschäftskontext für logisches Denken sowie zusätzliche Governance-Kontrollen bieten. Um sie unternehmensweit verantwortungsvoll einsetzen zu können, so der Plan.
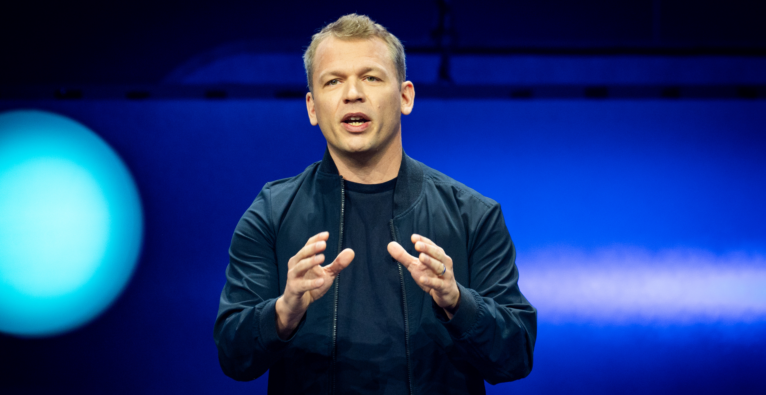
„Auf der SAP TechEd präsentieren Entwickler seit jeher die neuesten Innovationen“ sagt Philipp Herzig, CTO von SAP. „In diesem Jahr zeigen wir, wie KI nicht einfach nur lernt, Unternehmen zu verstehen, sondern auch Geschäftsprozesse abzuwickeln. In ‚Joule Work‘ machen Nutzer ihre Eingaben und erledigen Aufgaben in einer durchgängigen Anwendungsumgebung, in der gesamten SAP-Landschaft und darüber hinaus. Das ist die Neuerung, die wir in großem Maßstab bereitstellen.“
Die Basis von allem bildet die SAP Business AI Plattform. Sie sorge für eine schnellere Wertschöpfung, da Geschäftsprozesse von Anfang an verstanden würden, und biete eine höhere Genauigkeit. „Außerdem erfüllt sie die Anforderungen von Unternehmen, gewährleistet ab der ersten Implementierung einen sicheren, kontrollierten und konformen Betrieb und bietet eine einzigartige Kontextebene, die auf dem Prozess- und Branchenwissen aus über 50 Jahren aufbaut, das in jeder Agenten-Aktion verankert ist“, so Herzig weiter.
Code und No-Code
Gebaut werden KI-Agenten im „Joule Studio“. Das ist sowohl ohne Programmierkenntnisse per Klick-Baukasten (No-Code) möglich, als auch mit eigenem Code (Pro-Code). Dafür stehen über 70 verschiedene KI-Modelle zur Auswahl.
Durch neue Funktionen für „Joule Work“ sollen KI-Agenten noch wirkungsvoller komplexe Geschäftsprozesse über offene Protokolle (A2A und MCP) handhaben können. Diese Innovationen machen „Joule Work“ leistungsfähiger, um den Kontext besser zu verstehen, Entscheidungen zu treffen und mehrstufige Workflows über Unternehmenssysteme und Geschäftsbereiche hinweg auszuführen, so der Claim.
SAP erweitert seine KI-Plattform damit eigenen Angaben zufolge um eine neue Orchestrierungsschicht, damit Assistenten und Agenten komplexe, mehrstufige Abläufe über verschiedene SAP-Systeme hinweg zuverlässiger erledigen können. Der SAP Knowledge Graph soll künftig auch Daten aus kundeneigenen SAP- und Drittquellen einbinden, sodass Nutzer ihre Informationen in natürlicher Sprache durchsuchen und exakte, auf den eigenen Daten basierende Antworten erhalten.
Auch andere Anbieter-Einbindung möglich
Agenten anderer Anbieter sollen außerdem über ein kontrolliertes Agenten-Gateway sicher auf „Joule Agents“ zugreifen und mit ihnen zusammenarbeiten können, ohne dass „Kontrolle und Governance verloren gehen“. Das neue „SAP Enterprise AI Gateway“ bündelt zudem Authentifizierung, Richtlinien, Routing, Überwachung, Nutzungsverfolgung und Auditing des gesamten KI-Datenverkehrs im Unternehmen. Ergänzend sollen ein neuer „Joule Assistent“, der „SAP AI Agent Hub“ und ein „AI Governance Assistant“ Kunden dabei helfen, die EU-KI-Verordnung einzuhalten.
Beim „Tabular Foundation Model“ kündigt SAP das Modell „SAP-RPT-2.0“ an, das künftig auch Anomalien und Ausreißer in Tabellendaten erkennen soll. „SAP-RPT-TS“ hingegen soll Geschäftskennzahlen prognostizieren können.
Einsatz auf der ISS
„Es gibt große Weiterentwicklungen bei unseren Tabular Foundation Models“, ergänzt Herzig. „Daraus ist inzwischen eine ganze Modellfamilie geworden. Ein etwas ausgefallener technischer Ausblick ist, dass wir diese Modelle gemeinsam mit Hewlett Packard Enterprise auch auf der Internationalen Raumstation (ISS) einsetzen – für die vorausschauende Wartung im Weltraum.“ Das Modell soll zudem Ausfälle vorhersagen können, ohne dass die dafür benötigten Daten zur Erde übertragen werden müssen.
„SAP-RPT wurde generisch trainiert und kann– ähnlich wie große Sprachmodelle im Bereich Sprache – auf eine Vielzahl unterschiedlicher Anwendungsgebiete übertragen werden“, so Herzig weiter. „Creditplus verwendet solche Modelle beispielsweise für die Risikobewertung. Hitachi setzt sie für die vorausschauende Wartung seiner Maschinen ein. ‚Oxford Cancer‚ nutzt sie, um anhand von Proteinmarkern Krebserkrankungen bei Patienten besser vorherzusagen als mit bisherigen Modellen“, sagt er.
Wenn man sich die Internationale Raumstation ansehe, genauer gesagt das Columbus-Modul, in dem SAP das Modell einsetzt, gebe es dort enorme Datenmengen.
„Nicht einfach zur Erde herunterladen“
„Die Maschinen auf der ISS erzeugen Telemetriedaten, die sehr nützlich sind. Allerdings handelt es sich um rund zehn Gigabyte an Daten. Diese kann man nicht einfach zur Erde herunterladen – das würde viel zu lange dauern, wenn man schnell reagieren möchte, etwa um bestimmte Muster oder Auffälligkeiten in Zeitreihen zu erkennen“, erklärt Herzig. „Die Modelle lassen sich direkt vor Ort einsetzen, weil sie im Vergleich zu großen Sprachmodellen relativ klein sind. Sie können also unmittelbar auf der Raumstation betrieben werden. Und es ist kein Training erforderlich. Man speist die aktuellen Daten direkt als Live-Datenstrom ein und erhält sofort Vorhersagen.“
Der CTO sieht den Anwendungsfall auf der Raumstation nicht bloß als eine Marketingaktion, sondern als Zeugnis dafür, wie weit man gehen könne. Er sagt: „Wie nützlich ist die Technologie unter solch extremen Bedingungen? Auf der Erde ist heute vieles einfach. Wir haben schnelle Internetverbindungen und leistungsfähige GPUs. Bei solchen Anwendungsfällen spielt die Latenz kaum eine Rolle. Aber können wir auch in einer Umgebung echten Mehrwert schaffen, die nur eingeschränkt angebunden ist – oder zumindest sehr weit entfernt? Genau das wollten wir zeigen: Mit einer lokalen Verarbeitungsumgebung lassen sich Probleme lösen, deren Lösung sonst schwierig wäre, weil man zunächst sämtliche Daten zur Erde übertragen müsste. Anschließend müsste man sie dort auswerten und die Ergebnisse zurückübermitteln. Dann könnte es aber bereits zu spät sein.“
SAP löst „Data Drift“-Problem
Ein zentrales Problem bei klassischen KI-Modellen ist der sogenannte Data Drift: Data Scientists trainieren ihre Modelle auf historischen Daten, doch schon beim Abschluss des Trainings können sich die eintreffenden Daten statistisch verändert haben. Die neuen Modelle von SAP wollen genau hier ansetzen.
Man könne jederzeit aktuelle Daten ins Kontextfenster geben und erhalte darauf basierend präzise Vorhersagen, ohne neu trainieren zu müssen. „Veränderungen in Struktur oder Eigenschaften der Daten erkennt das Modell unmittelbar“, betont Herzig. „Das wollten wir demonstrieren: Müsste man bei veränderten Bedingungen erst alle Informationen zur Erde übertragen und das gesamte Modell neu trainieren, wäre es dafür viel zu spät. Dann würde man auf der ISS sagen: ‚Schön, dass ihr uns das jetzt mitteilt – aber das hättet ihr uns schon vor einem oder zwei Monaten sagen müssen‘.“