12.12.2025
KI-AGENTEN

KI-Agenten: „Wir haben mehr als 4.500 Entwicklerjahre eingespart“

Interview. Swami Sivasubramanian ist Vice President für Agentic AI bei Amazon Web Services (AWS). Im brutkasten-Interview spricht er über den aktuellen Stand bei KI-Agenten - und ihr langfristiges Potenzial.
/artikel/aws-ki-agenten
Swami Sivasubramanian spricht auf der TEDAI Vienna
Swami Sivasubramanian spricht auf der TEDAI Vienna | Foto: TEDAI Vienna

Swami Sivasubramanian ist Vice President für Agentic AI bei Amazon Web Services (AWS) – und zählt zu den Produkt- und Technologiearchitekten hinter zentralen KI- und Datenservices des Cloud-Anbieters. Bei AWS hat er die Entwicklung und Skalierung von unterschiedlichen Angeboten wie Amazon DynamoDB, Amazon SageMaker, Amazon Bedrock und Amazon Q maßgeblich mitverantwortet. In seiner aktuellen Rolle richtet Sivasubramanian den Fokus auf agentische KI. Anlässlich der TEDAI Vienna war Sivasubramanian Ende September im Wien.


brutkasten: Alle reden über KI-Agenten, es gibt einen Hype um das Thema. Aber wo stehen wir wirklich, was Agentic AI im Jahr 2025 angeht? 

Swami Sivasubramanian: KI‑Agenten sind eine der transformativsten Technologien unserer Zeit. Wenn man zwei Jahre zurückblickt, war das Gros der generativen KI im Kern Chatbot-artig: Man stellte eine Frage und bekam eine Antwort als Text, Bild oder Video.

Agentische KI unterscheidet sich in zwei Punkten. Erstens: Die großen Sprachmodelle dahinter sind inzwischen so intelligent, dass sie wirklich begründet entscheiden, planen und handeln können. Zweitens: Diese Handlungsfähigkeit verbindet sich mit der Rechenintelligenz. 

Stellen Sie sich eine Forscherin in einem Pharmalabor vor, die neue Proteine für die Wirkstoffforschung entwirft. Sie kann einem Agenten ein Ziel vorgeben – und der liefert nicht bloß Ideen, sondern recherchiert, erstellt einen Plan, zerlegt das Ziel in Schritte und wählt für jeden Schritt die passenden Werkzeuge. Diese Kombination aus Spitzenintelligenz und der Fähigkeit, tatsächlich zu handeln, verändert alles – das ist das Neue an agentischer KI.

Viele reden über Agenten, wenige nutzen sie wirklich. Was ist überhaupt ein Agent – und wie grenzt er sich von anderen KI-Anwendungen ab? Wenn ich ein Tool entwickle, dass LLM-basiert Eingangsrechnungen an die jeweiligen Unternehmensabteilungen zur Freigabe weiterleitet, ist das bereits ein Agent?

Nicht unbedingt. Ein Einzelschritt‑Workflow, bei dem man eine Aufgabe per Prompt auslöst und eine einmalige Entscheidung oder Ausgabe erhält, ist eher ein Chatbot. Ein Agent beginnt damit, dass der Nutzer oder die Nutzerin ein Ziel vorgibt. Der Agent zerlegt dieses Ziel selbstständig in umsetzbare Schritte, wählt aus den verfügbaren Tools die richtigen – und entwickelt bei Bedarf sogar neue Werkzeuge, indem er Codes schreibt und ausführt. 

Anschließend prüft er, ob das Ziel erreicht ist, reflektiert, wo er falsch lag, und iteriert den Plan. Ein Beispiel aus unserer Praxis: Wir haben 2023 Amazon Bedrock Agents und Software Development Agents mit Amazon Q Developer im Preview eingeführt, um mühsame Aufgaben in der Software-Entwicklung und -Betrieb zu automatisieren. Und heute haben wir eine agentenbasierte Entwicklungsumgebung (IDE) namens Kiro. 

Wir waren von den Möglichkeiten begeistert. Wir haben ein neuro‑symbolisches Verifikationssystem implementiert, um sicherzustellen, dass die APIs korrekt funktionieren. Dieses Zusammenspiel – ein reasoning‑fähiges Modell plus ein Verifikator, der kontinuierlich Rückmeldung gibt – macht aus einem bloßen LLM einen echten Agenten.

Sind Reasoning-Modelle also ein Schritt in Richtung Agenten?

Sie sind eine notwendige Zutat, aber nicht die einzige. Agenten müssen auch autonom handeln können: APIs aufrufen, Webseiten besuchen, eine Websuche durchführen oder Code schreiben und ausführen. Und weil Vertrauen essenziell ist, brauchen wir Verifikatoren. Neuro‑symbolische Systeme, die die Schritte eines Agenten automatisch prüfen und Rückmeldungen geben, erhöhen Genauigkeit und Zuverlässigkeit erheblich.

Wie beurteilen Sie die technologische Entwicklung bei Agentic AI? Sind KI-Agenten beispielsweise jetzt deutlich besser als vor einem Jahr?

Wir stehen am Anfang dieser Transformation, sehen aber bereits massive Effekte – besonders in einigen Domänen. Eine ist die Softwareentwicklung bei Modernisierungsprojekten.  Eine der stärksten Fähigkeiten von Amazon Q Developer ist die automatische Aktualisierung von Java-Versionen, wodurch Java-Anwendungen in einem Bruchteil der üblichen Zeit umgestellt werden können.

Wir haben diese Fähigkeit in Amazons interne Systeme integriert und konnten damit 30.000 Produktivanwendungen von älteren Java-Versionen, also beispielsweise 8 oder 11, auf Java 17 umstellen. Im Vergleich zur herkömmlichen Vorgehensweise haben wir mehr als 4.500 Entwicklerjahre eingespart. Durch die verbesserte Performance konnten wir zudem jährliche Kosteneinsparungen von 260 Millionen Dollar erreichen. Das ist nur ein Beispiel. Ähnliches passiert in der Wirkstoffforschung oder in der Präzisionslandwirtschaft. 

In Europa etwa setzt BMW, mit über 150.000 Beschäftigten, Agenten ein, um Serviceausfällen  schneller auf den Grund zu gehen. Mit rund 85 Prozent Trefferquote gelingt die Ursachenanalyse heute in deutlich kürzerer Zeit.

Auch in der Formel 1 zeigt der Einsatz einer KI-gestützten Lösung beeindruckende Ergebnisse: Durch die Implementierung von Amazon Bedrock, Bedrock Agents und Knowledge Bases konnte die Formel 1 die Lösungszeit bei Problemen um 86 Prozent, also von Wochen auf Minuten, und die anfängliche Analysezeit von über einem Tag auf unter 20 Minuten reduzieren.

In welchem Bereich war das BMW‑Beispiel konkret?

Es ging um Root Cause Analysis bei Systemausfällen in ihrer vernetzten Flotte von 23 Millionen Fahrzeugen. Ingenieurinnen und Ingenieure konnten die Zeit für die Fehlersuche erheblich verkürzen.

Das ist erst der Anfang. Neben Entwicklung und Betrieb sehen wir einen großen Sprung im Kundenservice. Jeder kennt das: Man ruft im Contact‑Center an, um den Status einer Bestellung zu klären. Agenten können hier Anfragen verstehen, Informationen zusammentragen und im Namen der Kundin oder des Kunden handeln. Solche agentischen Service‑Assistenten sind aus meiner Sicht reif für den breiten Einsatz.

Wie stellen Unternehmen sicher, dass Agenten zwar autonom handeln, aber wo nötig der Mensch eingebunden bleibt?

Das ist zentral. Teams müssen entscheiden, welche Entscheidungen vollständig automatisiert werden und bei welchen ein „Human‑in‑the‑Loop“ bestätigt. Ein einfaches Beispiel: die Rückerstattung im Kundenservice. Alles unter 10 bis 15 Euro kann beispielsweise – bei einer Modellgenauigkeit von 95 bis 99 Prozent – der Agent automatisch abwickeln. Liegt der Betrag darüber, prüft ein Mensch und gibt frei. Das ist ein risikobasierter, regelbasierter Ansatz. 

In Hochrisikoumgebungen – Gesundheit, Finanzregulierung, Grundrechte – ist besondere Sorgfalt nötig: Agenten sollen dort Menschen befähigen, fundierte Entscheidungen zu treffen. Kurz: Man braucht einen klaren Risikomanagement‑Rahmen für den Einsatz von Agenten.

Bedeutet das auch, dass sich nach Branche unterscheidet, wie geeignet KI-Agenten sind?

Genau. Branchen haben unterschiedliche Regulierungen – aber fast überall gibt es viele Backend‑Aufgaben, die heute noch manuell und ineffizient erledigt werden. Nehmen Sie Spesen: Eine E‑Mail mit Beleg kommt an, Daten werden händisch in ein anderes System übertragen. Das lässt sich durch Agenten automatisieren.

In der Software ist es ähnlich: Nicht nur neue Features schreiben, sondern auch Upgrades, Wartung und Performance‑Optimierung sind typische „Routinearbeiten“. Agenten können diesen nicht differenzierenden Aufwand übernehmen. Darum erhöhen sie bereits heute die Geschwindigkeit und Produktivität in vielen Bereichen.

Technologisch geht es rasant voran. Aber was bremst Unternehmen in der Einführung?

Ich sehe drei Hürden. Erstens: Der Sprung vom Prototyp zur Produktion. Ein Proof of Concept auf dem Laptop ist in ein paar Wochen gebaut. Aber in Produktion braucht es Sicherheit, Identitäts‑ und Rechtemanagement, Gedächtnis und Personalisierung, die saubere, abgesicherte Integration mit Backend‑APIs und Microservices sowie Observability und Metriken. Das dauert heute oft Monate. Um diesen undifferenzierten Aufwand zu verringern, haben wir „Amazon Bedrock AgentCore“ entwickelt. Seit Oktober dieses Jahres ist es allgemein verfügbar.  

Zweitens: Es fehlten lange agentenfreundliche Frameworks. Viele Open‑Source‑Ansätze arbeiten mit festen „Chains“ oder Flows. Doch mit wachsender Modellintelligenz braucht man Frameworks, in denen nicht Entwickler die Abläufe vordefinieren, sondern das Modell den Workflow dynamisch erzeugt. Wir haben dafür „Strand Agents“ als Open Source veröffentlicht; innerhalb von zwei bis drei Monaten erreichte das Projekt rund eine Million Downloads, und mehr als ein Dutzend Modellanbieter und andere trugen dazu bei. 

Drittens: Daten. Ohne einen soliden Datenunterbau und Zugriff auf die relevanten Systeme können Agenten keine guten Entscheidungen treffen. Unternehmen, die ihre Datenlandschaft für Agenten vorbereiten und optimieren, werden den größten Nutzen daraus ziehen.

Warum haben Sie das Framework als Open Source veröffentlicht?

Wir sind in den „Day‑Zero“‑Tagen der agentischen KI. Da ist offener Ideenaustausch essenziell. Ein Framework muss modell- und anwendungsneutral sein, sonst setzt es sich nicht breit durch. Außerdem wollen wir diese Basistechnologie allen Entwicklern und Anbietern zugänglich machen.

Das entspricht unserer Open‑Source‑Strategie seit den frühen AWS‑Jahren: Wir sind etwa einer der größten Beitragsleister zu PostgreSQL, wir haben Amazon Linux aufgebaut und mit OpenSearch ein offenes Such‑Ökosystem vorangetrieben. In der Formationsphase hilft Offenheit der gesamten Community.

Viele unserer Leser:innen sind Gründer:innen oder auch gründungsinteressierte Personen. Wenn Agenten die Produktivität in der Softwareentwicklung so stark steigern, werden Teams dann deutlich kleiner? 

Wir sehen klar, dass das Entwicklungstempo in KI‑nativen Teams massiv steigt.  Kürzlich haben wir die bereits erwähnte agentische Integrierte Entwicklungsumgebung (IDE) „Kiro“ vorgestellt. Anders als klassische Entwicklungsumgebungen und KI-gestützte Programmierassistenten arbeitet Kiro nach dem Prinzip der spezifikationsgesteuerten Entwicklung: Man beschreibt in natürlicher Sprache, was man entwickeln möchte. Der Agent generiert dann von Anfang bis Ende die komplette Architektur, den Code, die Tests und die Dokumentation.

Aufgaben, für die früher Teams mit 20 oder 30 Personen nötig waren, schafft heute eine Handvoll Leute. Das Team, das Kiro baut, nutzt das Tool selbst und hat seine Commit‑Geschwindigkeit im Schnitt mindestens verdoppelt, teilweise noch stärker. Ich erwarte deshalb mehr Zwei‑bis‑Vier‑Personen‑Startups. Die Limitierung verlagert sich weg von der Teamgröße hin zur Fähigkeit, Agenten präzise zu steuern. 

Manche nehmen an, dass durch Agenten die Rolle von Junior-Entwickler:innen stark reduziert oder komplett wegfallen werden. Stimmen Sie zu?

Nein. Junior‑Entwickler:innen bleiben ein wichtiger Bestandteil. Sie haben mit diesen Werkzeugen gelernt und für sie ist das Entwickeln mit KI völlig selbstverständlich. Das beobachte ich sowohl in Projekten mit Studierenden als auch mit Schülerinnen und Schülern. Die Tools beschleunigen alle; Senior‑Leute bringen zusätzlich Erfahrung und wissen, wo die Stolpersteine liegen. Das beste Team ist eine Mischung aus beidem – talentierte Juniors und erfahrene Seniors, die zusammen Agenten sinnvoll einsetzen.

Deine ungelesenen Artikel:
15.09.2026

Ablatic AI: Linzer LLM Talos spielt ohne VC-Kapital in einer Liga mit internationalen KI-Playern

Das nun gelaunchte Large Language Model (LLM) Talos des Linzer Startups Ablatic AI kann sich in mehreren Benchmarks mit den internationalen KI-Giganten messen. Co-Founder und CEO Florian Zimmermann erklärte uns, wie das ohne VC-Kapital möglich ist und wie man nun den Markt erobern will.
/artikel/ablatic-ai-linzer-llm-talos-spielt-ohne-vc-kapital-in-einer-liga-mit-internationalen-ki-playern
15.09.2026

Ablatic AI: Linzer LLM Talos spielt ohne VC-Kapital in einer Liga mit internationalen KI-Playern

Das nun gelaunchte Large Language Model (LLM) Talos des Linzer Startups Ablatic AI kann sich in mehreren Benchmarks mit den internationalen KI-Giganten messen. Co-Founder und CEO Florian Zimmermann erklärte uns, wie das ohne VC-Kapital möglich ist und wie man nun den Markt erobern will.
/artikel/ablatic-ai-linzer-llm-talos-spielt-ohne-vc-kapital-in-einer-liga-mit-internationalen-ki-playern
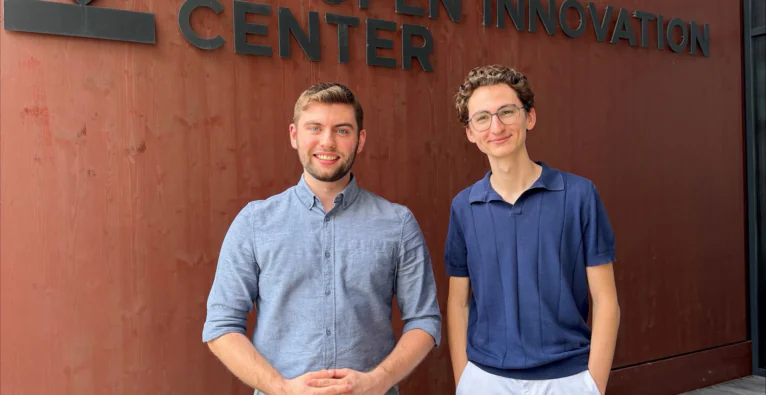
Die Ablatic-AI-Gründer vl. Florian Zimmermann (CEO) und Julian Mauerkirchner (CTO) | (c) Ablatic AI

Wieder einmal ist es Linz. Die Stahlstadt mausert sich immer mehr zu Österreichs KI-Hauptstadt und auch eines der bislang sicher ambitioniertesten Startups in dem Bereich kommt von dort: Ablatic AI. Mit Talos wagt es sich über die Herausforderung schlechthin in der KI-Welt: ein eigenes Large Language Model (LLM) – brutkasten berichtete bereits.

Bei einer Benchmark vor Sol von OpenAI

Nun erfolgte der offizielle Launch und Ablatic gab erste Benchmark-Vergleiche aus (siehe Tabelle unten). An Claude Opus 5 kommt man demnach noch in keiner Kategorie ganz heran, in mehreren aber ziemlich nahe. DeepSeek V4 kann man dagegen gleich bei drei Werten schlagen, Qwen3.8 von Alibaba bei zwei und OpenAIs Flagship-Modell GPT-5.6 Sol immerhin bei einem, konkret der exakten Befolgung schriftlicher Anweisungen (IFBench). Unterm Strich spielt das Linzer LLM also in den vorgelegten Benchmarks in der internationalen Top-Liga mit.

„Es kann ja nicht sein, dass es in Europa nur Mistral gibt“

Aber warum überhaupt noch ein weiteres LLM? „Julian [Anm. Mauerkirchner] und ich kennen uns schon seit der Schule. Später haben wir als Unternehmer damit gestartet, Legacy-ERP-Systeme zu erneuern. Dabei sind wir auf ein Problem gestoßen: Wir konnten dafür aus Daten-Gründen keine US-KI-Systeme nutzen“, erzählt CEO Florian Zimmermann, der Ablatic AI gemeinsam mit Julian Mauerkirchner (CTO) gegründet hat, im Gespräch mit brutkasten. Man habe nur Mistral aus Frankreich oder Open-Source-Modelle verwenden können. „Mistral war für den Zweck aber nicht passend und unser Business Case bald tot“.

Mit dem Entschluss, eine neue Idee zu verfolgen, sei daher auch eine neue Motivation einher gegangen: „Es kann ja nicht sein, dass es in Europa nur Mistral gibt“, so Zimmermann. Man habe sich danach mit der Johannes Kepler Universität Linz (JKU) kurzgeschlossen und sei darüber auch zur AI Factory Austria AI:AT gekommen, wo man wiederum im Rahmen des EuroHPC-Programms europäische Hochleistungsrechenressourcen nutzt, um das Modell zu trainieren. „Ohne diese EU-Ressourcen würde es kostentechnisch überhaupt nicht gehen“, sagt Zimmermann.

Öffentliche Forschungsergebnisse statt eigenes Riesen-Research-Team

Doch auch mit diesen Ressourcen – wie lässt sich ein konkurrenzfähiges LLM mit einem kleinen Team und bislang gänzlich ohne VC-Kapital umsetzen? Schließlich beschäftigen die globalen KI-Player, mit denen sich Ablatic misst, riesige Teams. Mistral etwa ist mit seiner kürzlich kommuniziert Drei-Milliarden-Euro-Finanzierungsrunde im Vergleich zu Anthropic und OpenAI nach wie vor ein kleiner Fisch (brutkasten analysierte).

„Wir können kein 200-köpfiges Research-Team finanzieren und gleich von 0 auf 100 gehen, also greifen wir auf Bestehendes zurück“, erklärt der Gründer. Konkret verwende man einerseits Open-Source-Layer und code sie auf die eigenen Bedürfnisse um. Andererseits nutze man die neuesten Forschungsergebnisse von Universitäten wie dem MIT oder Stanford, die laufend über die Plattform arXiv veröffentlicht werden. „Wir orientieren uns an der Frontier-Forschung. Wir analysieren die Paper, legen die Erkenntnisse auf unsere Architektur um und testen es durch. Vieles davon funktioniert nicht, aber alles was funktioniert, bringt uns weiter“, so Zimmermann.

Mehr als 100 B2B-Testkunden – viele konvertieren gleich zum Launch

Die Beta-Version wurde nun bereits seit einiger Zeit mit mehr als 100 Unternehmen getestet – Ablatic konzentriert sich nämlich vorerst klar auf den B2B-Markt. Man habe für diese Tests schnell auch größere Unternehmen und Konzerne gewonnen. „Ich bin dafür wochenlang gesessen, habe Leute angeschrieben und einen Call nach dem anderen gemacht“, räumt Zimmermann ein. Dass man ein eigenes LLM und nicht nur eine Oberfläche baue, sei dabei zum entscheidenden Bonus geworden. „Und dass wir von der JKU kommen und im EuroHPC-Programm sind, hat unsere Glaubwürdigkeit enorm gesteigert“, sagt der Gründer.

Jetzt zum Launch würden viele der Testkunden bereits zu regulären Nutzern konvertieren, viele weitere noch die Testphase abschließen, mit dem Vorhaben, das dann auch zu tun, verrät Zimmermann. „Wir werden nicht 100 Prozent, aber einen Großteil konvertieren können“, ist er sicher. Punkten will Ablatic dabei nicht nur mit der europäischen Herkunft – Stichwort: Digitale Souveränität – sondern auch mit dem Pricing. „Wir haben eine relativ effiziente Architektur. Wir können kostengünstig hosten und das an die Kunden weitergeben“, so der CEO. Dass der offizielle Launch genau jetzt erfolgt, hat vor allem mit dem Gründungsprozess zu tun, der länger dauerte, als erhofft. „Ich gründe nie wieder im Sommer ein Unternehmen“, sagt der Gründer lachend.

Investment geplant: „Das Ziel ist definitiv, keine kleine Bude zu bleiben“

Und wie geht es weiter? „Wir wollen zuerst im DACH-Raum Fuß fassen und ohne große weitere Standorte skalieren. Dann wollen wir es auf Europa hochziehen“, erläutert Zimmermann. Auf Dauer werde dabei auch die Aufnahme von VC-Kapital relevant, vor allem wenn es darum gehe, die nächste Modell-Version herauszubringen. „Dann ist es wichtig, dass man schnell skaliert und iteriert. Wir sind stolz darauf, dass wir ein Modell ohne VC-Kapital trainiert haben. Wir haben gezeigt, dass auch so Großes möglich ist. Aber langfristig ist es völlig logisch, dass wir Kapital aufnehmen müssen“, sagt der Gründer.

Und es seien bereits mehrere Investoren aktiv auf das Team zugekommen, mit einigen befinde man sich schon in Gesprächen. „Das Ziel ist definitiv, keine kleine Bude zu bleiben, sondern eine größere Firma zu werden. Wir wollen jedenfalls nicht in Vergessenheit geraten“, so Zimmermann. Und der Zeitpunkt sei angesichts der Souveränitätsdebatte gut.


Benchmark-Vergleichstabelle

Anmerkungen zur Tabelle:

  • Fette Zahlen: Höchster Wert in der jeweiligen Zeile unter den Vergleichsmodellen.
  • „text-only“: Das Modell verarbeitet keine Bilder/visuellen Dokumente, weshalb OmniDocBench nicht anwendbar ist.
  • „–“: Kein veröffentlichter Wert vorhanden.

Kurzerklärungen der Benchmarks

  • Agents‘ Last Exam (UC Berkeley): Prüft langwierige, echte Arbeitsaufgaben an einem Computer (Terminal und Bildschirm zusammen), bewertet anhand des fertigen Gesamtergebnisses.
  • AutomationBench (Zapier): Testet 600 Business-Workflows über 47 simulierte Unternehmens-Softwaretools hinweg, die vollständig durchgehend ausgeführt werden müssen.
  • Toolathlon: Bewertet das Erledigen von Aufgaben in echter Büro-Software (z. B. E-Mail, Kalender, Tabellenkalkulationen und GitHub) über deren direkte Schnittstellen.
  • BrowseComp (OpenAI): Stellt schwierige Fragen, deren Antworten über das gesamte Internet verstreut liegen und durch selbstständiges Surfen recherchiert werden müssen.
  • DeepSWE v1.1 (Datacurve): Misst das eigenständige Beheben echter Softwareprobleme (Bugs) in bestehenden Quellcode-Sammlungen. Hinweis: Talos-1 wurde hierfür nicht optimiert und liegt 22 Punkte hinter der Spitze zurück.
  • OmniDocBench: Bewertet das fehlerfreie Lesen und Verstehen echter Dokumente inklusive visueller Layouts, Tabellen und mathematischer Formeln.
  • IFBench: Prüft die exakte Einhaltung von schriftlich vorgegebenen Anweisungen und Formatierungsregeln.
Toll dass du so interessiert bist!
Hinterlasse uns bitte ein Feedback über den Button am linken Bildschirmrand.
Und klicke hier um die ganze Welt von der brutkasten zu entdecken.

brutkasten Newsletter

Aktuelle Nachrichten zu Startups, den neuesten Innovationen und politischen Entscheidungen zur Digitalisierung direkt in dein Postfach. Wähle aus unserer breiten Palette an Newslettern den passenden für dich.

Montag, Mittwoch und Freitag

AI Summaries

KI-Agenten: „Wir haben mehr als 4.500 Entwicklerjahre eingespart“

AI Kontextualisierung

Welche gesellschaftspolitischen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

KI-Agenten: „Wir haben mehr als 4.500 Entwicklerjahre eingespart“

AI Kontextualisierung

Welche wirtschaftlichen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

KI-Agenten: „Wir haben mehr als 4.500 Entwicklerjahre eingespart“

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Innovationsmanager:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

KI-Agenten: „Wir haben mehr als 4.500 Entwicklerjahre eingespart“

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Investor:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

KI-Agenten: „Wir haben mehr als 4.500 Entwicklerjahre eingespart“

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Politiker:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

KI-Agenten: „Wir haben mehr als 4.500 Entwicklerjahre eingespart“

AI Kontextualisierung

Was könnte das Bigger Picture von den Inhalten dieses Artikels sein?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

KI-Agenten: „Wir haben mehr als 4.500 Entwicklerjahre eingespart“

AI Kontextualisierung

Wer sind die relevantesten Personen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

KI-Agenten: „Wir haben mehr als 4.500 Entwicklerjahre eingespart“

AI Kontextualisierung

Wer sind die relevantesten Organisationen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

KI-Agenten: „Wir haben mehr als 4.500 Entwicklerjahre eingespart“