25.01.2023

So diskriminiert KI: ChatGPT entfacht Debatte neu

Jasmin Reisinger und Gabriele Bolek-Fügl erklären, wie Diskriminierung in der Künstlichen Intelligenz und in der KI-Branche funktionieren und was man dagegen tun könnte. Der Fall ChatGPT hat die Debatte neu entfacht.
/artikel/so-diskriminiert-ki-chatgpt-entfacht-debatte-neu
Gabriele Bolek-Fügl und Jasmin Reisinger (Women in AI Austria) sprechen über ChatGPT und Ethik in der KI © Bolek-Fügl; Reisinger; Parradee/AdobeStock

Die Kritik um ChatGPT und die Möglichkeit, rassistische oder sexistische Statements im Zuge der Nutzung zu erhalten, gibt es bereits länger. Mittlerweile hat sich die Debatte über die ethischen Aspekte der Künstlichen Intelligenz (KI) erweitert. Der Chatbot wurde soweit trainiert, dass scheinbar keine diskriminierenden Statements mehr vorkommen. Die erfolgreiche Behebung hat seinen Preis. Wie Recherchen des Time Magazins zeigen, hat die hinter ChatGPT stehende Firma OpenAI Textausschnitte an das Trainingsdatenunternehmen Sama gesendet, um die KI zu trainieren. Klickarbeiter:innen der Sama-Außenstelle in Kenia wurden dafür laut Time Magazin nicht nur mit unter zwei Dollar die Stunde für ihre Arbeit bezahlt, sondern waren mit teils traumatisierenden Inhalten konfrontiert. Um eine KI manuell zu trainieren, braucht es nämlich Menschen, die die toxischen Inhalte als solche klassifizieren und der KI übermitteln. 

Solche Skandale werfen Fragen auf: Wie können einer KI diskriminierende, sexistische und rassistische Inhalte abtrainiert werden, ohne zugleich in der realen Welt prekäre Arbeitsbedingungen zu bestärken? Im gemeinnützigen Verein “Women in Artificial Intelligence Austria” setzen sich mehrere AI-Expertinnen nicht nur mit den technologischen Aspekten, sondern auch mit der Geschlechterlücke in der Künstlichen Intelligenz auseinander. Damit widmen sie sich einer speziellen Form der Diskriminierung in der KI. Im brutkasten-Gespräch bewerten Jasmin Reisinger und Gabriele Bolek-Fügl von “Women in AI” den Fall ChatGPT und erklären die technologischen Hintergründe und was man in der Branche beachten muss, sodass gerechte Rahmenbedingungen herrschen – sowohl in der Technologie, als auch in der Realität.


Was ist Diskriminierung in der AI und wie findet sie aktuell statt?

Jasmin und Gabriele: Eine Künstliche Intelligenz lernt selbständig auf Basis von sehr vielen Datensätzen, die der Mensch bereitstellt. Diese Datensätze bilden entweder eine Momentaufnahme ab, die die bisherige Realität darstellt – inklusive der Diskriminierung von einzelnen Menschengruppen. Oder sie bilden eine Situation ab, von der umfassende Datensätze vorhanden sind. Bei zweiterem bedeutet dies, dass selten eine ausgewogene Bandbreite der Menschen in den Daten vorhanden ist. Außerdem werden die KI-Modelle von einer homogenen Gruppe von Programmierer:innen erstellt. Auch das ist eine Quelle dafür, dass sich Vorurteile in den Ergebnissen von KI-Systemen widerspiegeln.

Diskriminierung im Kontext von KI bedeutet demnach, dass Interpretationsmuster vom Menschen übernommen werden können. So können negative Diskriminierungsstrukturen entstehen. Um dies zu vermeiden, müssen Trainingsdaten „bereinigt“ oder „ergänzt“ werden und das ist bei Millionen von Datensätzen keine einfache Aufgabe. Vor dieser Herausforderung steht aktuell OpenAI und deren Chatbot “ChatGPT”, der für sein Können bestaunt und für seine Limitierungen kritisiert wird.

Wie beobachtet bzw. bewertet ihr diesen Sachverhalt rund um OpenAI und deren Umgang mit externen Angestellten?

Jasmin: Der Time-Artikel zu OpenAI hat bestimmte Vorgänge im Hintergrund sehr detailliert beleuchtet, die der breiten Öffentlichkeit vorher unbekannt waren. Wie bereits erwähnt ist die Bereinigung von riesigen Datensätzen eine Herausforderung, zu der es oft (noch) keine einfache Lösung gibt. Dabei sind zwei Perspektiven zu beachten: Einerseits sollte die KI-Industrie bei heiklen Datensätzen nicht auf einfache Lösungen zurückgreifen, die auf der Ausbeutung billiger Arbeitskräfte beruhen, um schnellen technologischen Fortschritt zu erreichen. Andererseits ist die Involvierung von diversen Personengruppen mit unterschiedlichen Lebensrealitäten zu begrüßen, da sie für ausgewogenere KI-Modelle stehen können.

Gabriele: Die Reaktion der Öffentlichkeit wird OpenAI langfristig dazu zwingen, ethisch unbedenkliche Wege zu finden, wie sie ihre Technologie weiterentwickeln können. Ethische Beurteilungen unterliegen immer einem gesellschaftlichen Diskurs und da stehen wir noch ganz am Anfang. Es ist jedenfalls zu begrüßen, dass die Daten von ChatGPT nach unterschiedlichen Kriterien beurteilt und bereinigt wurden. KI-Systeme anderer Hersteller mussten aufgrund von nicht ausreichend bereinigten Daten bald wieder deaktiviert werden. Ethik ist nicht einfach da. Ethische KI-Systeme bedeuten die Abbildung der gesellschaftlichen Meinung zu einem bestimmten Zeitpunkt, und diese kann sich rasch ändern. Und es bedeutet viel Arbeit, diese Meinung in tausenden Datensätzen abzubilden.

Jasmin: Ich möchte an dieser Stelle jedoch betonen, dass nicht alle KI-Systeme mit Hochrisiko-Datensätzen gefüttert werden (müssen). Die Qualitätssicherung in der Glasindustrie z.B. ist weit weg von Themen wie Rassismus oder Sexismus, und verbessert tatsächlich die Arbeitsprozesse für Arbeitnehmer:innen. Den Fall OpenAI werden wir weiterhin beobachten.

Viele Menschen vergessen bei Künstlicher Intelligenz die manuellen Aspekte – also die Content Moderation hinter der Menschen stehen, die ungefiltert mit sämtlichen Daten konfrontiert werden. Teilweise kann das auch zu einer psychischen Belastung für Arbeitnehmer:inenn führen. Wie kann man sich diese manuellen Aspekte vorstellen?

Jasmin: Um Datensätze als Basis für KI-Systeme nutzen zu können, müssen diese einem „Labeling“ unterzogen werden. Der Mensch kennzeichnet dann z.B. die Merkmale einer Katze, damit die KI lernt, woran sie eine Katze erkennen oder von einem Hund unterscheiden kann.

Bei Millionen von Datensätzen muss z.B. im Falle von OpenAI gekennzeichnet werden, welche Daten diskriminierend, rassistisch, sexistisch usw. sind, um qualitativ hochwertige, wertfreie Datensätze zu erzielen. Erst dann kann die KI „gute“ Ergebnisse liefern. Vor- oder Nachteile gibt es in dem Sinne nicht. Der steigende Bedarf an „Data Labeling“ wird viele Unternehmen lediglich vor eine Herausforderung stellen.

Gabriele: Dass potentiell traumatisierende Informationen von Menschen angesehen werden müssen, um ein Daten Labeling für KI durchzuführen, ist der Realität geschuldet. Diese Daten wurden aus einem bestimmten Grund von Menschen erstellt. Dieser war nicht, als Trainingsdaten für eine KI herangezogen zu werden, sondern Angst, Betroffenheit oder Ähnliches bei anderen Personen zu erzeugen.

OpenAI ist nicht das erste und vermutlich nicht das letzte Unternehmen, bei dem so etwas vorkommt. Gerade in Anbetracht der Tatsache, dass wir jetzt auf einen AI-Hype blicken: Wie muss sich die AI-Branche verändern, damit solche Arbeitsbedingungen aufgehalten werden?

Gabriele: Wollen wir ethische KI-Systeme, so muss vorher ein gesellschaftlicher Diskurs zu den ethischen Werten stattfinden. Dann kann versucht werden, diese in den KI-Modellen abzubilden. Bekannt ist das Beispiel, ob ein selbstfahrendes Auto eher einen 80-jährigen Mann bei einer unausweichlichen Kollision verletzen soll oder die Mutter mit Kinderwagen.

Die Auslagerung des “Data Labeling” in andere Länder mit billigeren Kostenstrukturen und Lohn hat auch mehrere Aspekte. Aus Diversitätsgründen ist es einerseits zu begrüßen, außerdem werden so auch Arbeitsplätze mit für die Länder meist gutem Lohn geschaffen. Andererseits werden häufig jene Sachverhalte ausgelagert, die man den eigenen Angestellten nicht zumuten möchte. Das ist ethisch sicher bedenklich.

Da Millionen von Datensätzen gelabelt werden müssen, sind die KI-Unternehmen darauf angewiesen, in andere Länder auszuweichen, um die Kosten für die KI-Systeme nicht immens hoch werden zu lassen und die Arbeit parallel zur Entwicklung durchzuführen. Kosten KI-Systeme letztendlich zu viel, werden sie von nur wenigen Kund:innen genutzt. Es verzerrt den Wettbewerb noch mehr, wenn diese Methodik nur einem kleinen Benutzerkreis zur Verfügung steht, der sich hohe Kosten leisten kann.

Jasmin: Zusätzlich ist noch der geografische Aspekt zu beachten. In Europa herrscht im Gegensatz zu den USA ein Bestreben nach regulierten, vertrauenswürdigen KI-Systemen. Hier wird durchaus betont, dass sowohl in technischer als auch gesellschaftlicher Hinsicht, kein Schaden angerichtet, sondern ausschließlich positive wirtschaftliche und gesellschaftliche Beiträge geleistet werden sollen. Ein konkreter Rechtsrahmen fehlt zwar auch hier noch, aber die Richtung stimmt. Langfristig werden Länder wie die USA an Regulierungen und Leitlinien feilen müssen, wenn sie das Vertrauen der Benutzer:innen erlangen bzw. behalten wollen.
Deine ungelesenen Artikel:
vor 2 Stunden

SAP stellt neue KI-Tools vor – eines davon kommt auf der Internationalen Raumstation (ISS) zum Einsatz

SAP arbeitet an einem umfassenderen Einsatz von KI in Unternehmen und stellte dafür bei seiner Entwicklerkonferenz TechEd neue Technologien vor. Sie sollen unter anderem die Zusammenarbeit von KI-Agenten verbessern, ihren Einsatz besser kontrollierbar machen und Datenanalysen selbst unter den besonderen Bedingungen der ISS ermöglichen.
/artikel/sap-stellt-neue-ki-tools-vor-eines-davon-kommt-auf-der-internationalen-raumstation-iss-zum-einsatz
vor 2 Stunden

SAP stellt neue KI-Tools vor – eines davon kommt auf der Internationalen Raumstation (ISS) zum Einsatz

SAP arbeitet an einem umfassenderen Einsatz von KI in Unternehmen und stellte dafür bei seiner Entwicklerkonferenz TechEd neue Technologien vor. Sie sollen unter anderem die Zusammenarbeit von KI-Agenten verbessern, ihren Einsatz besser kontrollierbar machen und Datenanalysen selbst unter den besonderen Bedingungen der ISS ermöglichen.
/artikel/sap-stellt-neue-ki-tools-vor-eines-davon-kommt-auf-der-internationalen-raumstation-iss-zum-einsatz
ISS, SAP
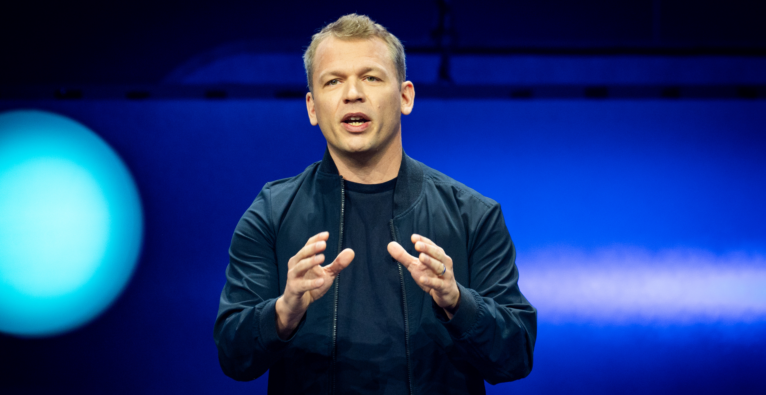
Philipp Herzig, CTO SAP I © SAP

SAP hat auf seiner jährlichen Entwicklerkonferenz „SAP TechEd“ Ende Oktober eine Reihe von KI-Innovationen bekannt gegeben, die das SAP-Portfolio für Entwickler erweitern. Erweiterungen der Joule-Lösungen und der SAP Business AI Platform – einschließlich des neuesten Foundation Models von SAP für tabellarische Daten – sollen neue Tools zur Entwicklung und Erweiterung von KI-Agenten bereitstellen. Zugleich sollen sie den Agenten Daten- und Geschäftskontext für logisches Denken sowie zusätzliche Governance-Kontrollen bieten. Um sie unternehmensweit verantwortungsvoll einsetzen zu können, so der Plan.

SAP Business AI Plattform als Basis

„Auf der SAP TechEd präsentieren Entwickler seit jeher die neuesten Innovationen“ sagt Philipp Herzig, CTO von SAP. „In diesem Jahr zeigen wir, wie KI nicht einfach nur lernt, Unternehmen zu verstehen, sondern auch Geschäftsprozesse abzuwickeln. In ‚Joule Work‘ machen Nutzer ihre Eingaben und erledigen Aufgaben in einer durchgängigen Anwendungsumgebung, in der gesamten SAP-Landschaft und darüber hinaus. Das ist die Neuerung, die wir in großem Maßstab bereitstellen.“

Die Basis von allem bildet die SAP Business AI Plattform. Sie sorge für eine schnellere Wertschöpfung, da Geschäftsprozesse von Anfang an verstanden würden, und biete eine höhere Genauigkeit. „Außerdem erfüllt sie die Anforderungen von Unternehmen, gewährleistet ab der ersten Implementierung einen sicheren, kontrollierten und konformen Betrieb und bietet eine einzigartige Kontextebene, die auf dem Prozess- und Branchenwissen aus über 50 Jahren aufbaut, das in jeder Agenten-Aktion verankert ist“, so Herzig weiter.

Code und No-Code

Gebaut werden KI-Agenten im „Joule Studio“. Das ist sowohl ohne Programmierkenntnisse per Klick-Baukasten (No-Code) möglich, als auch mit eigenem Code (Pro-Code). Dafür stehen über 70 verschiedene KI-Modelle zur Auswahl.

Durch neue Funktionen für „Joule Work“ sollen KI-Agenten noch wirkungsvoller komplexe Geschäftsprozesse über offene Protokolle (A2A und MCP) handhaben können. Diese Innovationen machen „Joule Work“ leistungsfähiger, um den Kontext besser zu verstehen, Entscheidungen zu treffen und mehrstufige Workflows über Unternehmenssysteme und Geschäftsbereiche hinweg auszuführen, so der Claim.

SAP erweitert seine KI-Plattform damit eigenen Angaben zufolge um eine neue Orchestrierungsschicht, damit Assistenten und Agenten komplexe, mehrstufige Abläufe über verschiedene SAP-Systeme hinweg zuverlässiger erledigen können. Der SAP Knowledge Graph soll künftig auch Daten aus kundeneigenen SAP- und Drittquellen einbinden, sodass Nutzer ihre Informationen in natürlicher Sprache durchsuchen und exakte, auf den eigenen Daten basierende Antworten erhalten.

Auch andere Anbieter-Einbindung möglich

Agenten anderer Anbieter sollen außerdem über ein kontrolliertes Agenten-Gateway sicher auf „Joule Agents“ zugreifen und mit ihnen zusammenarbeiten können, ohne dass „Kontrolle und Governance verloren gehen“. Das neue „SAP Enterprise AI Gateway“ bündelt zudem Authentifizierung, Richtlinien, Routing, Überwachung, Nutzungsverfolgung und Auditing des gesamten KI-Datenverkehrs im Unternehmen. Ergänzend sollen ein neuer „Joule Assistent“, der „SAP AI Agent Hub“ und ein „AI Governance Assistant“ Kunden dabei helfen, die EU-KI-Verordnung einzuhalten.

Beim „Tabular Foundation Model“ kündigt SAP das Modell „SAP-RPT-2.0“ an, das künftig auch Anomalien und Ausreißer in Tabellendaten erkennen soll. „SAP-RPT-TS“ hingegen soll Geschäftskennzahlen prognostizieren können.

Einsatz auf der ISS

„Es gibt große Weiterentwicklungen bei unseren Tabular Foundation Models“, ergänzt Herzig. „Daraus ist inzwischen eine ganze Modellfamilie geworden. Ein etwas ausgefallener technischer Ausblick ist, dass wir diese Modelle gemeinsam mit Hewlett Packard Enterprise auch auf der Internationalen Raumstation (ISS) einsetzen – für die vorausschauende Wartung im Weltraum.“ Das Modell soll zudem Ausfälle vorhersagen können, ohne dass die dafür benötigten Daten zur Erde übertragen werden müssen.

„SAP-RPT wurde generisch trainiert und kann– ähnlich wie große Sprachmodelle im Bereich Sprache – auf eine Vielzahl unterschiedlicher Anwendungsgebiete übertragen werden“, so Herzig weiter. „Creditplus verwendet solche Modelle beispielsweise für die Risikobewertung. Hitachi setzt sie für die vorausschauende Wartung seiner Maschinen ein. ‚Oxford Cancer‚ nutzt sie, um anhand von Proteinmarkern Krebserkrankungen bei Patienten besser vorherzusagen als mit bisherigen Modellen“, sagt er.

Wenn man sich die Internationale Raumstation ansehe, genauer gesagt das Columbus-Modul, in dem SAP das Modell einsetzt, gebe es dort enorme Datenmengen.

„Nicht einfach zur Erde herunterladen“

„Die Maschinen auf der ISS erzeugen Telemetriedaten, die sehr nützlich sind. Allerdings handelt es sich um rund zehn Gigabyte an Daten. Diese kann man nicht einfach zur Erde herunterladen – das würde viel zu lange dauern, wenn man schnell reagieren möchte, etwa um bestimmte Muster oder Auffälligkeiten in Zeitreihen zu erkennen“, erklärt Herzig. „Die Modelle lassen sich direkt vor Ort einsetzen, weil sie im Vergleich zu großen Sprachmodellen relativ klein sind. Sie können also unmittelbar auf der Raumstation betrieben werden. Und es ist kein Training erforderlich. Man speist die aktuellen Daten direkt als Live-Datenstrom ein und erhält sofort Vorhersagen.“

Der CTO sieht den Anwendungsfall auf der Raumstation nicht bloß als eine Marketingaktion, sondern als Zeugnis dafür, wie weit man gehen könne. Er sagt: „Wie nützlich ist die Technologie unter solch extremen Bedingungen? Auf der Erde ist heute vieles einfach. Wir haben schnelle Internetverbindungen und leistungsfähige GPUs. Bei solchen Anwendungsfällen spielt die Latenz kaum eine Rolle. Aber können wir auch in einer Umgebung echten Mehrwert schaffen, die nur eingeschränkt angebunden ist – oder zumindest sehr weit entfernt? Genau das wollten wir zeigen: Mit einer lokalen Verarbeitungsumgebung lassen sich Probleme lösen, deren Lösung sonst schwierig wäre, weil man zunächst sämtliche Daten zur Erde übertragen müsste. Anschließend müsste man sie dort auswerten und die Ergebnisse zurückübermitteln. Dann könnte es aber bereits zu spät sein.“

SAP löst „Data Drift“-Problem

Ein zentrales Problem bei klassischen KI-Modellen ist der sogenannte Data Drift: Data Scientists trainieren ihre Modelle auf historischen Daten, doch schon beim Abschluss des Trainings können sich die eintreffenden Daten statistisch verändert haben. Die neuen Modelle von SAP wollen genau hier ansetzen.

Man könne jederzeit aktuelle Daten ins Kontextfenster geben und erhalte darauf basierend präzise Vorhersagen, ohne neu trainieren zu müssen. „Veränderungen in Struktur oder Eigenschaften der Daten erkennt das Modell unmittelbar“, betont Herzig. „Das wollten wir demonstrieren: Müsste man bei veränderten Bedingungen erst alle Informationen zur Erde übertragen und das gesamte Modell neu trainieren, wäre es dafür viel zu spät. Dann würde man auf der ISS sagen: ‚Schön, dass ihr uns das jetzt mitteilt – aber das hättet ihr uns schon vor einem oder zwei Monaten sagen müssen‘.“

Toll dass du so interessiert bist!
Hinterlasse uns bitte ein Feedback über den Button am linken Bildschirmrand.
Und klicke hier um die ganze Welt von der brutkasten zu entdecken.

brutkasten Newsletter

Aktuelle Nachrichten zu Startups, den neuesten Innovationen und politischen Entscheidungen zur Digitalisierung direkt in dein Postfach. Wähle aus unserer breiten Palette an Newslettern den passenden für dich.

Montag, Mittwoch und Freitag

AI Summaries

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Welche gesellschaftspolitischen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Welche wirtschaftlichen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Innovationsmanager:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Investor:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Politiker:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Was könnte das Bigger Picture von den Inhalten dieses Artikels sein?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Wer sind die relevantesten Personen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Wer sind die relevantesten Organisationen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu