16.07.2020

Auch Künstliche Intelligenz kann menschliche Schwächen haben

Algorithmen erkennen Sarkasmus, aber sie können vergessen – zwei Themen, denen sich Wissenschaftlerinnen des Software Competence Center Hagenberg in ihren Forschungsarbeiten widmen.
/artikel/kunstliche-intelligenz-menschliche-schwachen
Künstliche Intelligenz hat in Österreich keinen hohen Stellenwert.
(c) Adobe Stock / metamorworks
sponsored

Das Erkennen von Sarkasmus im Web ist sogar für Menschen ein schwieriges Unterfangen – für eine künstliche Intelligenz ist es umso komplizierter. Dabei wäre dies etwa im Onlinehandel wichtig, damit zum Beispiel eine Onlinerezension richtig eingeschätzt werden kann. Bisherige Sarkasmusdetektionen fokussieren sich auf die Erkennung von Sarkasmus auf Satzebene oder für eine spezielle Textphrase. Das Problem dabei ist, dass es oft unmöglich ist, einen einzelnen sarkastischen Satz zu identifizieren, ohne den Kontext zu kennen.

(c) SCCH

Diesem Thema widmet sich Nicole Schwarz vom Software Competence Center Hagenberg (SCCH) in ihrer Arbeit. „Ich arbeite dabei mit einem Deep Neural Network, das jeweils ein Convolutional Neural Network und ein Long-Short-Term Memory Network umfasst“, so Schwarz. Beide Methoden können Texte effizient klassifizieren, die vom Kontext des jeweiligen Textes abhängen, da beide über Speichereinheiten verfügen, um sich bereits gelernte Wörter aus dem Text merken zu können.

Die Ergebnisse der Arbeit zeigen somit, dass Deep Neural Networks die Genauigkeit simplerer Modelle übertreffen können – allerdings mit einem Wermutstropfen: Gäbe es mehr und bessere Daten, so könnten auch genauere Resultate erzielt werden.

Auch eine Künstliche Intelligenz kann vergessen
(c) SCCH

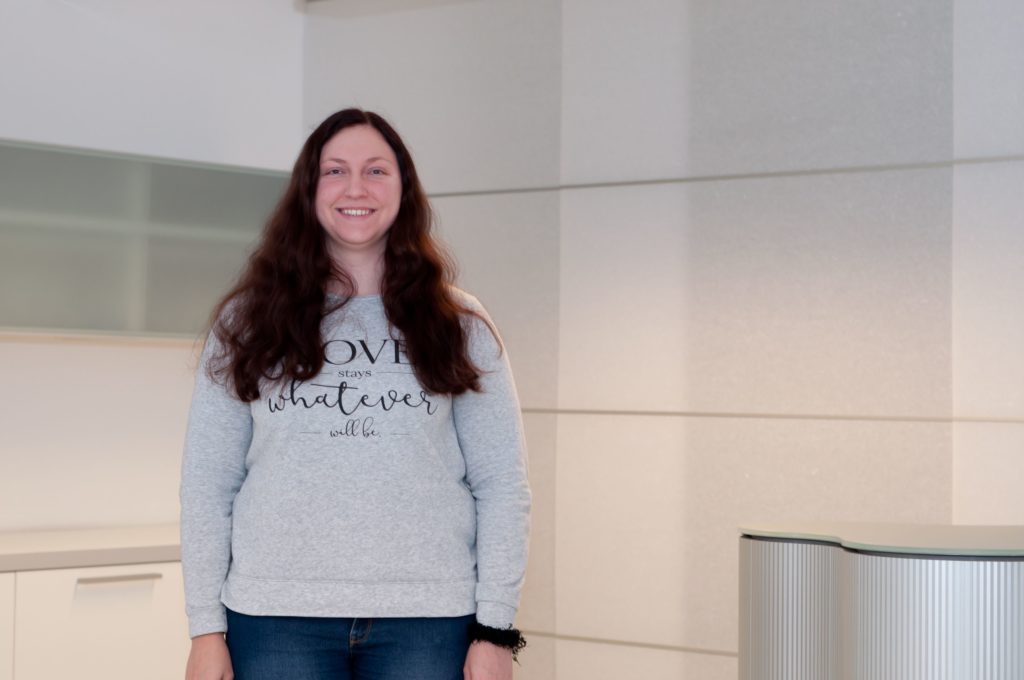
Daten sind zugleich das Thema, dem sich Sabrina Luftensteiner in ihrer Arbeit widmet. Denn Vergessen ist kein menschliches Privileg, wie sie erklärt: Auch bei Maschinen ist das sogenannte „katastrophale Vergessen“ ein Problem.

„Ich erforsche das katastrophale Vergessen, welches beim Online-Learning von neuronalen Netzen auftritt und wodurch gelernte Zusammenhänge in bestehenden Modellen bei der Anpassung mit neuen Daten verdrängt werden“, sagt Luftensteiner. Ein Modell komplett neu zu erstellen ist zum Beispiel in der Industrie aber oft zu aufwendig oder gar nicht möglich – etwa wegen des Überschreitens zeitlicher Limits oder auch, weil hier benötigte Daten fehlen.

In diesem Kontext sind auch zensurierte Daten ein Problem: Diese entstehen zum Beispiel durch physikalische Grenzen von Sensoren (z.B. Hitzesensoren) – sie führen zu einem verfälschten Modell, da die im Training genutzten Daten nicht den realen Daten entsprechen. „Ich habe daher ein Framework entwickelt, welches diese Ansätze einbindet und auf verschiedene Datensätze anwendbar ist. Durch die diversen Konfigurationsmöglichkeiten ist dieses Framework gegen das Vergessen in diversen Bereichen – vor allem aber in der Industrie – anwendbar“, so Luftensteiner.

Deine ungelesenen Artikel:
vor 3 Stunden

Allocator One: Wiener VC-Dachfonds vermeldet finales Closing von erstem Fonds bei über 100 Mio. Dollar

Allocator One gab zudem Performance-Zahlen zu den bislang mehr als 40 Fonds-Investments seit dem Start im Juli 2024 heraus.
/artikel/allocator-one-wiener-vc-dachfonds-vermeldet-finales-closing-von-erstem-fonds-bei-ueber-100-mio-dollar
vor 3 Stunden

Allocator One: Wiener VC-Dachfonds vermeldet finales Closing von erstem Fonds bei über 100 Mio. Dollar

Allocator One gab zudem Performance-Zahlen zu den bislang mehr als 40 Fonds-Investments seit dem Start im Juli 2024 heraus.
/artikel/allocator-one-wiener-vc-dachfonds-vermeldet-finales-closing-von-erstem-fonds-bei-ueber-100-mio-dollar
Michael Ströck und Felix Staeritz haben Allocator One gegründet | (c) Michael Ströck / brutkasten
v.l. Michael Ströck und Felix Staeritz haben Allocator One gegründet | (c) Michael Ströck / brutkasten

Bereits seit Juli 2024 ist Allocator One, der Fund of Funds mit Sitz in Wien, aktiv – brutkasten berichtete bereits mehrmals. Die Zielsetzung hat sich seitdem nicht verändert: Die besten First-Time- bzw. Zweitfonds sogenannter „Emerging Manager“ ausfindig machen und in diese investieren. Schon bislang investierte der Dachfonds nach eigenen Angaben so in mehr als 40 Fonds – zuletzt etwa Noctua Science Ventures. Die Ticketgröße liegt dabei zwischen zwei und zehn Millionen.

„Daten-Problem“: KI hilft bei Auswahl der Fonds

Allocator One verbindet dabei menschliche Investmententscheidungen mit seiner Fondsinfrastruktur-Plattform Infra One und mit dem KI-Agenten Ori. „Außergewöhnliche Fondsmanager zu finden, sollte nicht davon abhängen, wessen Pitch einen zufällig erreicht. Wir analysieren systematisch Tausende von Emerging Managern weltweit und kombinieren proprietäre Daten mit Investmentkompetenz, um die wenigen Spezialisten mit echtem Wettbewerbsvorteil zu identifizieren und zu unterstützen, bevor der breite Markt sie entdeckt“, sagt dazu Michael Ströck, gemeinsam mit Felix Staeritz Gründungspartner von Allocator One.

Die besten Spezialisten zu finden sei „ein Daten-Problem – und wir behandeln es auch so“, ergänzt Staeritz. Jährlich würden weltweit etwa 1.000 neue Emerging-Manager-Fonds aufgelegt. Man schätze, dass man rund 80 Prozent davon sichte, heißt es von Allocator One. Knapp 20 Prozent der Bewerber kämen in die engere Auswahl für ein Interview. Nach Abschluss der Due Diligence investiere man in die obersten ein Prozent der Manager.

23 Prozent überzeichnetes Closing, bislang indirekt in 17 Unicorns investiert

Nun verkündete Allocator One das finale Closing des ersten Anchor-Fonds „Flagship Fund I“ im September. Dieser sei um 23 Prozent überzeichnet und kam letztlich auf ein (zugesagtes) Volumen von mehr als 100 Millionen US-Dollar. Die Investoren seien Family Offices, erfolgreiche Technologieunternehmer, erfahrene Venture-Investoren und institutionelle Anleger aus mehr als 25 Ländern. Der Dachfonds investiert in Fonds der Jahrgänge 2023 bis 2026.

Zeitgleich nennt Allocator One Performance-Zahlen zu den mehr als 40 Fonds-Investments der vergangenen zwei Jahre. Bei mehr als 60 Prozent davon sei man der größte Investor. Insgesamt sei man über die Beteiligungen indirekt in 600 Unternehmen investiert, darunter 17 Unicorns wie Lovable, Thinking Machines und xAI. 11 Prozent des eingezahlten Kapitals habe man bereits zurückgezahlt

Toll dass du so interessiert bist!
Hinterlasse uns bitte ein Feedback über den Button am linken Bildschirmrand.
Und klicke hier um die ganze Welt von der brutkasten zu entdecken.

brutkasten Newsletter

Aktuelle Nachrichten zu Startups, den neuesten Innovationen und politischen Entscheidungen zur Digitalisierung direkt in dein Postfach. Wähle aus unserer breiten Palette an Newslettern den passenden für dich.

Montag, Mittwoch und Freitag

AI Summaries

Auch Künstliche Intelligenz kann menschliche Schwächen haben

  • Das Erkennen von Sarkasmus im Web ist sogar für Menschen ein schwieriges Unterfangen – für eine künstliche Intelligenz ist es umso komplizierter.
  • Diesem Thema widmet sich Nicole Schwarz vom Software Competence Center Hagenberg (SCCH) in ihrer Arbeit.
  • „Ich arbeite dabei mit einem Deep Neural Network, das jeweils ein Convolutional Neural Network und ein Long-Short-Term Memory Network umfasst“, so Schwarz.
  • Daten sind zugleich das Thema, dem sich Sabrina Luftensteiner in ihrer Arbeit widmet.
  • Denn Vergessen ist kein menschliches Privileg, wie sie erklärt: Auch bei Maschinen ist das sogenannte „katastrophale Vergessen“ ein Problem.
  • In diesem Kontext sind auch zensurierte Daten ein Problem: Diese entstehen zum Beispiel durch physikalische Grenzen von Sensoren – sie führen zu einem verfälschten Modell, da die im Training genutzten Daten nicht den realen Daten entsprechen.

AI Kontextualisierung

Welche gesellschaftspolitischen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Auch Künstliche Intelligenz kann menschliche Schwächen haben

  • Das Erkennen von Sarkasmus im Web ist sogar für Menschen ein schwieriges Unterfangen – für eine künstliche Intelligenz ist es umso komplizierter.
  • Diesem Thema widmet sich Nicole Schwarz vom Software Competence Center Hagenberg (SCCH) in ihrer Arbeit.
  • „Ich arbeite dabei mit einem Deep Neural Network, das jeweils ein Convolutional Neural Network und ein Long-Short-Term Memory Network umfasst“, so Schwarz.
  • Daten sind zugleich das Thema, dem sich Sabrina Luftensteiner in ihrer Arbeit widmet.
  • Denn Vergessen ist kein menschliches Privileg, wie sie erklärt: Auch bei Maschinen ist das sogenannte „katastrophale Vergessen“ ein Problem.
  • In diesem Kontext sind auch zensurierte Daten ein Problem: Diese entstehen zum Beispiel durch physikalische Grenzen von Sensoren – sie führen zu einem verfälschten Modell, da die im Training genutzten Daten nicht den realen Daten entsprechen.

AI Kontextualisierung

Welche wirtschaftlichen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Auch Künstliche Intelligenz kann menschliche Schwächen haben

  • Das Erkennen von Sarkasmus im Web ist sogar für Menschen ein schwieriges Unterfangen – für eine künstliche Intelligenz ist es umso komplizierter.
  • Diesem Thema widmet sich Nicole Schwarz vom Software Competence Center Hagenberg (SCCH) in ihrer Arbeit.
  • „Ich arbeite dabei mit einem Deep Neural Network, das jeweils ein Convolutional Neural Network und ein Long-Short-Term Memory Network umfasst“, so Schwarz.
  • Daten sind zugleich das Thema, dem sich Sabrina Luftensteiner in ihrer Arbeit widmet.
  • Denn Vergessen ist kein menschliches Privileg, wie sie erklärt: Auch bei Maschinen ist das sogenannte „katastrophale Vergessen“ ein Problem.
  • In diesem Kontext sind auch zensurierte Daten ein Problem: Diese entstehen zum Beispiel durch physikalische Grenzen von Sensoren – sie führen zu einem verfälschten Modell, da die im Training genutzten Daten nicht den realen Daten entsprechen.

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Innovationsmanager:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Auch Künstliche Intelligenz kann menschliche Schwächen haben

  • Das Erkennen von Sarkasmus im Web ist sogar für Menschen ein schwieriges Unterfangen – für eine künstliche Intelligenz ist es umso komplizierter.
  • Diesem Thema widmet sich Nicole Schwarz vom Software Competence Center Hagenberg (SCCH) in ihrer Arbeit.
  • „Ich arbeite dabei mit einem Deep Neural Network, das jeweils ein Convolutional Neural Network und ein Long-Short-Term Memory Network umfasst“, so Schwarz.
  • Daten sind zugleich das Thema, dem sich Sabrina Luftensteiner in ihrer Arbeit widmet.
  • Denn Vergessen ist kein menschliches Privileg, wie sie erklärt: Auch bei Maschinen ist das sogenannte „katastrophale Vergessen“ ein Problem.
  • In diesem Kontext sind auch zensurierte Daten ein Problem: Diese entstehen zum Beispiel durch physikalische Grenzen von Sensoren – sie führen zu einem verfälschten Modell, da die im Training genutzten Daten nicht den realen Daten entsprechen.

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Investor:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Auch Künstliche Intelligenz kann menschliche Schwächen haben

  • Das Erkennen von Sarkasmus im Web ist sogar für Menschen ein schwieriges Unterfangen – für eine künstliche Intelligenz ist es umso komplizierter.
  • Diesem Thema widmet sich Nicole Schwarz vom Software Competence Center Hagenberg (SCCH) in ihrer Arbeit.
  • „Ich arbeite dabei mit einem Deep Neural Network, das jeweils ein Convolutional Neural Network und ein Long-Short-Term Memory Network umfasst“, so Schwarz.
  • Daten sind zugleich das Thema, dem sich Sabrina Luftensteiner in ihrer Arbeit widmet.
  • Denn Vergessen ist kein menschliches Privileg, wie sie erklärt: Auch bei Maschinen ist das sogenannte „katastrophale Vergessen“ ein Problem.
  • In diesem Kontext sind auch zensurierte Daten ein Problem: Diese entstehen zum Beispiel durch physikalische Grenzen von Sensoren – sie führen zu einem verfälschten Modell, da die im Training genutzten Daten nicht den realen Daten entsprechen.

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Politiker:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Auch Künstliche Intelligenz kann menschliche Schwächen haben

  • Das Erkennen von Sarkasmus im Web ist sogar für Menschen ein schwieriges Unterfangen – für eine künstliche Intelligenz ist es umso komplizierter.
  • Diesem Thema widmet sich Nicole Schwarz vom Software Competence Center Hagenberg (SCCH) in ihrer Arbeit.
  • „Ich arbeite dabei mit einem Deep Neural Network, das jeweils ein Convolutional Neural Network und ein Long-Short-Term Memory Network umfasst“, so Schwarz.
  • Daten sind zugleich das Thema, dem sich Sabrina Luftensteiner in ihrer Arbeit widmet.
  • Denn Vergessen ist kein menschliches Privileg, wie sie erklärt: Auch bei Maschinen ist das sogenannte „katastrophale Vergessen“ ein Problem.
  • In diesem Kontext sind auch zensurierte Daten ein Problem: Diese entstehen zum Beispiel durch physikalische Grenzen von Sensoren – sie führen zu einem verfälschten Modell, da die im Training genutzten Daten nicht den realen Daten entsprechen.

AI Kontextualisierung

Was könnte das Bigger Picture von den Inhalten dieses Artikels sein?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Auch Künstliche Intelligenz kann menschliche Schwächen haben

  • Das Erkennen von Sarkasmus im Web ist sogar für Menschen ein schwieriges Unterfangen – für eine künstliche Intelligenz ist es umso komplizierter.
  • Diesem Thema widmet sich Nicole Schwarz vom Software Competence Center Hagenberg (SCCH) in ihrer Arbeit.
  • „Ich arbeite dabei mit einem Deep Neural Network, das jeweils ein Convolutional Neural Network und ein Long-Short-Term Memory Network umfasst“, so Schwarz.
  • Daten sind zugleich das Thema, dem sich Sabrina Luftensteiner in ihrer Arbeit widmet.
  • Denn Vergessen ist kein menschliches Privileg, wie sie erklärt: Auch bei Maschinen ist das sogenannte „katastrophale Vergessen“ ein Problem.
  • In diesem Kontext sind auch zensurierte Daten ein Problem: Diese entstehen zum Beispiel durch physikalische Grenzen von Sensoren – sie führen zu einem verfälschten Modell, da die im Training genutzten Daten nicht den realen Daten entsprechen.

AI Kontextualisierung

Wer sind die relevantesten Personen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Auch Künstliche Intelligenz kann menschliche Schwächen haben

  • Das Erkennen von Sarkasmus im Web ist sogar für Menschen ein schwieriges Unterfangen – für eine künstliche Intelligenz ist es umso komplizierter.
  • Diesem Thema widmet sich Nicole Schwarz vom Software Competence Center Hagenberg (SCCH) in ihrer Arbeit.
  • „Ich arbeite dabei mit einem Deep Neural Network, das jeweils ein Convolutional Neural Network und ein Long-Short-Term Memory Network umfasst“, so Schwarz.
  • Daten sind zugleich das Thema, dem sich Sabrina Luftensteiner in ihrer Arbeit widmet.
  • Denn Vergessen ist kein menschliches Privileg, wie sie erklärt: Auch bei Maschinen ist das sogenannte „katastrophale Vergessen“ ein Problem.
  • In diesem Kontext sind auch zensurierte Daten ein Problem: Diese entstehen zum Beispiel durch physikalische Grenzen von Sensoren – sie führen zu einem verfälschten Modell, da die im Training genutzten Daten nicht den realen Daten entsprechen.

AI Kontextualisierung

Wer sind die relevantesten Organisationen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Auch Künstliche Intelligenz kann menschliche Schwächen haben

  • Das Erkennen von Sarkasmus im Web ist sogar für Menschen ein schwieriges Unterfangen – für eine künstliche Intelligenz ist es umso komplizierter.
  • Diesem Thema widmet sich Nicole Schwarz vom Software Competence Center Hagenberg (SCCH) in ihrer Arbeit.
  • „Ich arbeite dabei mit einem Deep Neural Network, das jeweils ein Convolutional Neural Network und ein Long-Short-Term Memory Network umfasst“, so Schwarz.
  • Daten sind zugleich das Thema, dem sich Sabrina Luftensteiner in ihrer Arbeit widmet.
  • Denn Vergessen ist kein menschliches Privileg, wie sie erklärt: Auch bei Maschinen ist das sogenannte „katastrophale Vergessen“ ein Problem.
  • In diesem Kontext sind auch zensurierte Daten ein Problem: Diese entstehen zum Beispiel durch physikalische Grenzen von Sensoren – sie führen zu einem verfälschten Modell, da die im Training genutzten Daten nicht den realen Daten entsprechen.