Wolt: Neuer Lieferservice in Wien liefert „alles“ in 35 Minuten
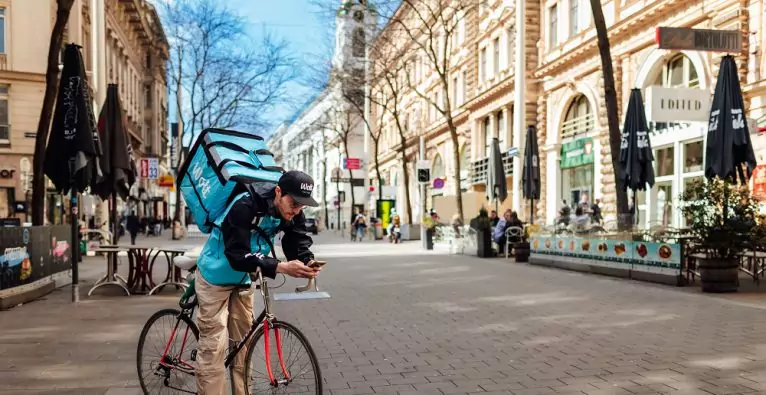
Lieferando, Mjam, Gurkerl und Co. bekommen Konkurrenz aus dem Norden. Der finnische Lieferdienst Wolt macht ab heute die Wiener Straßen mit blauen Lieferboxen unsicher.
Ein neuer Lieferdienst ist „in town“. Allerdings nicht nur für Essen wie bei Lieferando, Mjam & Co., sondern für „Alles“. Der finnische Lieferdienst Wolt schlägt in Wien auf und liefert ab sofort Produkte aus Geschäften und Restaurants aus der nächsten Umgebung. Neben Essen werden dabei auch Backwaren, Lebensmittel, Blumen und Kosmetikprodukte zugestellt. Innerhalb von maximal 35 Minuten soll die Ware bei den Kund:innen ankommen.
„Wolt ist nicht einfach nur ein Telefonbuch für Restaurants und den Einzelhandel. Wir machen es möglich, dass Menschen in Hunderten von Städten in 25 Ländern alles, was sie brauchen, schnell und zuverlässig an ihre Haustür geliefert bekommen. Und das auch noch CO2-neutral“, erklärt Clemens Brugger, General Manager für Wolt in Österreich.
Digitales Shopping-Center gegen Amazon
Wolt möchte als eine Art digitales Shopping-Center fungieren. Vom obersten Stock, wo sich meist die Restaurants befinden, bis zum untersten, wo die Supermärkte untergebracht sind, will Wolt sein Angebot spannen. Dabei sieht sich Wolt vor allem als Technologieplattform und Logistiker und will digitale Infrastruktur bieten, um lokale Anbieter:innen und Einzelhändler:innen zu unterstützen. Damit will das 2014 in Helsinki gegründete Lieferdienst-Startup internationalen Internetversandriesen wie Amazon die Stirn bieten.
Nachhaltiges Wachstum
Vorerst liefert Wolt nur in den inneren Wiener Gemeindebezirken (1-9) und teilweise im 10. Bezirk. „Dies ist wichtig, um Prozesse anzupassen und unsere Kund:innen sowie Fahrer:innen zufriedenzustellen“, sagt Clemens Brugger. So möchte das Unternehmen nachhaltig wachsen.
Mensch statt Maschine
Die Lieferdienste übernehmen Fahrradkuriere, die als freie Dienstnehmer:innen angestellt sind und die angeblich den „höchsten Verdienst in der Branche“ erhalten. Im Kundenservice arbeiten statt Chat-Bots echte Menschen, die die Fragen der Kund:innen persönlich beantworten. Wolt möchte dadurch ein besseres Kundenerlebnis schaffen und „den Sektor perfektionieren“.
Keine echten Telefonnummern
Für die Sicherheit der Kund:innen soll außerdem sorgen, dass deren echte Telefonnummern nicht angezeigt werden. In der Vergangenheit landeten in der Branche etwa immer wieder Telefonnummern von Kund:innen bei betrügerischen Firmen und es soll zu Belästigungen gekommen sein. Daher werden bei Wolt-Bestellungen die echten Telefonnummern der Kund:innen unterdrückt. Über eine Proxynummer sollen diese aber für Rückfragen für die Fahrer:innen erreichbar sein.
Ablatic AI: Linzer LLM Talos spielt ohne VC-Kapital in einer Liga mit internationalen KI-Playern
Das nun gelaunchte Large Language Model (LLM) Talos des Linzer Startups Ablatic AI kann sich in mehreren Benchmarks mit den internationalen KI-Giganten messen. Co-Founder und CEO Florian Zimmermann erklärte uns, wie das ohne VC-Kapital möglich ist und wie man nun den Markt erobern will.
Ablatic AI: Linzer LLM Talos spielt ohne VC-Kapital in einer Liga mit internationalen KI-Playern
Das nun gelaunchte Large Language Model (LLM) Talos des Linzer Startups Ablatic AI kann sich in mehreren Benchmarks mit den internationalen KI-Giganten messen. Co-Founder und CEO Florian Zimmermann erklärte uns, wie das ohne VC-Kapital möglich ist und wie man nun den Markt erobern will.
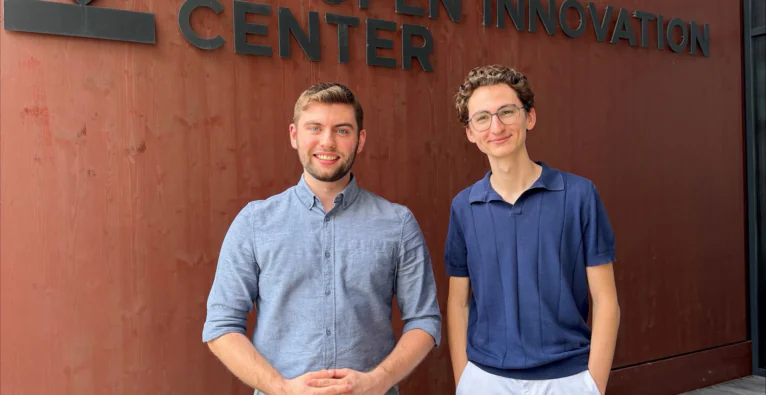
Die Ablatic-AI-Gründer vl. Florian Zimmermann (CEO) und Julian Mauerkirchner (CTO) | (c) Ablatic AI
Wieder einmal ist es Linz. Die Stahlstadt mausert sich immer mehr zu Österreichs KI-Hauptstadt und auch eines der bislang sicher ambitioniertesten Startups in dem Bereich kommt von dort: Ablatic AI. Mit Talos wagt es sich über die Herausforderung schlechthin in der KI-Welt: ein eigenes Large Language Model (LLM) – brutkasten berichtete bereits.
Bei einer Benchmark vor Sol von OpenAI
Nun erfolgte der offizielle Launch und Ablatic gab erste Benchmark-Vergleiche aus (siehe Tabelle unten). An Claude Opus 5 kommt man demnach noch in keiner Kategorie ganz heran, in mehreren aber ziemlich nahe. DeepSeek V4 kann man dagegen gleich bei drei Werten schlagen, Qwen3.8 von Alibaba bei zwei und OpenAIs Flagship-Modell GPT-5.6 Sol immerhin bei einem, konkret der exakten Befolgung schriftlicher Anweisungen (IFBench). Unterm Strich spielt das Linzer LLM also in den vorgelegten Benchmarks in der internationalen Top-Liga mit.
„Es kann ja nicht sein, dass es in Europa nur Mistral gibt“
Aber warum überhaupt noch ein weiteres LLM? „Julian [Anm. Mauerkirchner] und ich kennen uns schon seit der Schule. Später haben wir als Unternehmer damit gestartet, Legacy-ERP-Systeme zu erneuern. Dabei sind wir auf ein Problem gestoßen: Wir konnten dafür aus Daten-Gründen keine US-KI-Systeme nutzen“, erzählt CEO Florian Zimmermann, der Ablatic AI gemeinsam mit Julian Mauerkirchner (CTO) gegründet hat, im Gespräch mit brutkasten. Man habe nur Mistral aus Frankreich oder Open-Source-Modelle verwenden können. „Mistral war für den Zweck aber nicht passend und unser Business Case bald tot“.
Mit dem Entschluss, eine neue Idee zu verfolgen, sei daher auch eine neue Motivation einher gegangen: „Es kann ja nicht sein, dass es in Europa nur Mistral gibt“, so Zimmermann. Man habe sich danach mit der Johannes Kepler Universität Linz (JKU) kurzgeschlossen und sei darüber auch zur AI Factory Austria AI:AT gekommen, wo man wiederum im Rahmen des EuroHPC-Programms europäische Hochleistungsrechenressourcen nutzt, um das Modell zu trainieren. „Ohne diese EU-Ressourcen würde es kostentechnisch überhaupt nicht gehen“, sagt Zimmermann.
Doch auch mit diesen Ressourcen – wie lässt sich ein konkurrenzfähiges LLM mit einem kleinen Team und bislang gänzlich ohne VC-Kapital umsetzen? Schließlich beschäftigen die globalen KI-Player, mit denen sich Ablatic misst, riesige Teams. Mistral etwa ist mit seiner kürzlich kommuniziert Drei-Milliarden-Euro-Finanzierungsrunde im Vergleich zu Anthropic und OpenAI nach wie vor ein kleiner Fisch (brutkasten analysierte).
„Wir können kein 200-köpfiges Research-Team finanzieren und gleich von 0 auf 100 gehen, also greifen wir auf Bestehendes zurück“, erklärt der Gründer. Konkret verwende man einerseits Open-Source-Layer und code sie auf die eigenen Bedürfnisse um. Andererseits nutze man die neuesten Forschungsergebnisse von Universitäten wie dem MIT oder Stanford, die laufend über die Plattform arXiv veröffentlicht werden. „Wir orientieren uns an der Frontier-Forschung. Wir analysieren die Paper, legen die Erkenntnisse auf unsere Architektur um und testen es durch. Vieles davon funktioniert nicht, aber alles was funktioniert, bringt uns weiter“, so Zimmermann.
Mehr als 100 B2B-Testkunden – viele konvertieren gleich zum Launch
Die Beta-Version wurde nun bereits seit einiger Zeit mit mehr als 100 Unternehmen getestet – Ablatic konzentriert sich nämlich vorerst klar auf den B2B-Markt. Man habe für diese Tests schnell auch größere Unternehmen und Konzerne gewonnen. „Ich bin dafür wochenlang gesessen, habe Leute angeschrieben und einen Call nach dem anderen gemacht“, räumt Zimmermann ein. Dass man ein eigenes LLM und nicht nur eine Oberfläche baue, sei dabei zum entscheidenden Bonus geworden. „Und dass wir von der JKU kommen und im EuroHPC-Programm sind, hat unsere Glaubwürdigkeit enorm gesteigert“, sagt der Gründer.
Jetzt zum Launch würden viele der Testkunden bereits zu regulären Nutzern konvertieren, viele weitere noch die Testphase abschließen, mit dem Vorhaben, das dann auch zu tun, verrät Zimmermann. „Wir werden nicht 100 Prozent, aber einen Großteil konvertieren können“, ist er sicher. Punkten will Ablatic dabei nicht nur mit der europäischen Herkunft – Stichwort: Digitale Souveränität – sondern auch mit dem Pricing. „Wir haben eine relativ effiziente Architektur. Wir können kostengünstig hosten und das an die Kunden weitergeben“, so der CEO. Dass der offizielle Launch genau jetzt erfolgt, hat vor allem mit dem Gründungsprozess zu tun, der länger dauerte, als erhofft. „Ich gründe nie wieder im Sommer ein Unternehmen“, sagt der Gründer lachend.
Investment geplant: „Das Ziel ist definitiv, keine kleine Bude zu bleiben“
Und wie geht es weiter? „Wir wollen zuerst im DACH-Raum Fuß fassen und ohne große weitere Standorte skalieren. Dann wollen wir es auf Europa hochziehen“, erläutert Zimmermann. Auf Dauer werde dabei auch die Aufnahme von VC-Kapital relevant, vor allem wenn es darum gehe, die nächste Modell-Version herauszubringen. „Dann ist es wichtig, dass man schnell skaliert und iteriert. Wir sind stolz darauf, dass wir ein Modell ohne VC-Kapital trainiert haben. Wir haben gezeigt, dass auch so Großes möglich ist. Aber langfristig ist es völlig logisch, dass wir Kapital aufnehmen müssen“, sagt der Gründer.
Und es seien bereits mehrere Investoren aktiv auf das Team zugekommen, mit einigen befinde man sich schon in Gesprächen. „Das Ziel ist definitiv, keine kleine Bude zu bleiben, sondern eine größere Firma zu werden. Wir wollen jedenfalls nicht in Vergessenheit geraten“, so Zimmermann. Und der Zeitpunkt sei angesichts der Souveränitätsdebatte gut.
Benchmark-Vergleichstabelle
Anmerkungen zur Tabelle:
Fette Zahlen: Höchster Wert in der jeweiligen Zeile unter den Vergleichsmodellen.
„text-only“: Das Modell verarbeitet keine Bilder/visuellen Dokumente, weshalb OmniDocBench nicht anwendbar ist.
„–“: Kein veröffentlichter Wert vorhanden.
Kurzerklärungen der Benchmarks
Agents‘ Last Exam (UC Berkeley): Prüft langwierige, echte Arbeitsaufgaben an einem Computer (Terminal und Bildschirm zusammen), bewertet anhand des fertigen Gesamtergebnisses.
AutomationBench (Zapier): Testet 600 Business-Workflows über 47 simulierte Unternehmens-Softwaretools hinweg, die vollständig durchgehend ausgeführt werden müssen.
Toolathlon: Bewertet das Erledigen von Aufgaben in echter Büro-Software (z. B. E-Mail, Kalender, Tabellenkalkulationen und GitHub) über deren direkte Schnittstellen.
BrowseComp (OpenAI): Stellt schwierige Fragen, deren Antworten über das gesamte Internet verstreut liegen und durch selbstständiges Surfen recherchiert werden müssen.
DeepSWE v1.1 (Datacurve): Misst das eigenständige Beheben echter Softwareprobleme (Bugs) in bestehenden Quellcode-Sammlungen. Hinweis: Talos-1 wurde hierfür nicht optimiert und liegt 22 Punkte hinter der Spitze zurück.
OmniDocBench: Bewertet das fehlerfreie Lesen und Verstehen echter Dokumente inklusive visueller Layouts, Tabellen und mathematischer Formeln.
IFBench: Prüft die exakte Einhaltung von schriftlich vorgegebenen Anweisungen und Formatierungsregeln.
Aktuelle Nachrichten zu Startups, den neuesten Innovationen und politischen Entscheidungen zur Digitalisierung direkt in dein Postfach. Wähle aus unserer breiten Palette an Newslettern den passenden für dich.