15.07.2019

Was macht eigentlich ein Data Scientist?

Das Buzzword "Data Science" geistert derzeit durch die Innovationsabteilungen quer über alle Branchen hinweg. Der Job-Titel "Data Scientist" ist einer der häufigsten in einschlägigen Karriere-Plattformen. Doch worum geht es dabei eigentlich? Wir haben mit drei sehr unterschiedlichen Data Scientists gesprochen.
/artikel/was-macht-ein-data-scientist
Was macht eigentlich ein Data Scientist? Wir haben das Sclable-Data Science-Team gefragt
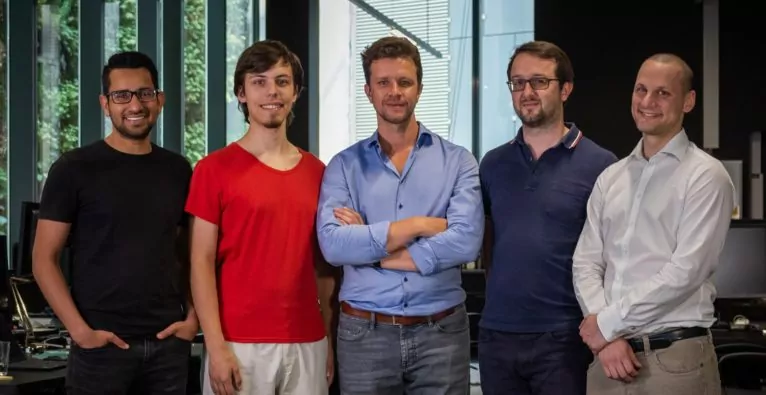
(c) Tobias Fittner: Das Sclable-AI- und Data Science-Team (vlnr.): Sanchit Singh, Ronald Luc, Frank Fichtenmüller, Charles Dietz und Viktor Sandner

„Data Science bezeichnet generell die Extraktion von Wissen aus Daten“ – so lautet die verkürzte Definition auf Wikipedia. Daraus lässt sich eines bereits klar ableiten: Der Beruf „Data Scientist“ lässt sich nicht auf einzelne spezifische Tätigkeiten eingrenzen. Tatsächlich bietet der Job, der auf einschlägigen Karriere-Plattformen von Unternehmen jeder Größe derzeit stark nachgefragt wird, einen großen Spielraum. Dabei sind ganz unterschiedliche Kompetenzen vonnöten.

+++ Mehr zum Thema Human Ressources +++

„Lauter offene Münder“

Ein Unternehmen, bei dem Data Science zum Kerngeschäft gehört, ist der Business Accelerator Sclable mit Hauptsitz im Wiener weXelerate. Dort unterstützt man seit sieben Jahren Kunden aus der nationalen und internationalen traditionellen Industrie wie Umdasch Group Ventures und ihr Schwesterunternehmen Doka oder Palfinger in Sachen digitale Transformation. Ein entscheidender Faktor ist dabei die Nutzung von Daten, um Prozesse effizienter zu machen. „Du löst dabei etwas, das für dich eine absolute ‚low hanging fruit‘ ist. Aber beim Kunden siehst du bei der Präsentation der Ergebnisse lauter offene Münder“, sagt Viktor Sandner, Head of Data Science and Methodology bei Sclable.

„Es gibt keinen Data Science Fullstack Developer“

Die Nische Finden

Sandner kommt eigentlich aus dem Biotech-Bereich. „Ich bin in meiner Forschung mit Excel-Tabellen bald an meine Grenzen gestoßen. Ich habe daher programmieren gelernt und es hat sich plötzlich eine ganze neue Welt offenbart“, erzählt er. So habe er begonnen, nach Daten-Lösungen für die gesamte Branche zu suchen und sei damit zum „Experten mit einem gewissen Extra“ geworden – konkret im Bereich Statistik. Denn eines müsse man im breiten Feld der Data Science finden, um zu reüssieren: Eine Nische.

Diverses Data Science-Team

„Es gibt keinen Data Science Fullstack Developer“, sagt auch Sandners Kollege Ronald Luc, Machine Learning Engineer bei Sclable, und ebenfalls ein „Data Scientist“. Man brauche ein diverses Team. Während sich Viktor Sandner mit statistischen Methoden auf die Suche nach teilweise versteckten Korrelationen in großen Datensets macht, ist Lucs Domäne die Vorhersage von Werten mit Hilfe von Deep Learning – teilweise auf Basis von durch seinen Kollegen aufbereiteten Daten. „Manchmal sind aber gar keine Daten vorhanden. Dann erstelle ich mit Hilfe von detaillierten Interviews ein mathematisches Modell zur Vorhersage“, erklärt Luc.

Es braucht nicht immer Deep Learning

Ein weiteres Feld der Data Science deckt bei Sclable Sanchit Singh ab. Der Head of Computer Vision beschäftigt sich mit der Analyse von zwei- und dreidimensionalen Bild-Inhalten. Auch er arbeitet mit Deep Learning – das sei aber nicht zwingend notwendig. „Es lässt sich vieles mit dem klassischen Computer Vision-Ansatz machen, wo auf Basis von mathematischen Modellen Vergleiche durchgeführt werden und Klassifikationen erstellt werden können“, erklärt Singh. Als Beispiel nennt er, der ursprünglich aus dem Medizin-Bereich kommt, die Hautkrebs-Forschung. Dort könnten Bilder von Haut-Anomalien etwa nach dem Abgleich der Parameter Farbe, Form und Symmetrie sehr treffsicher kategorisiert werden. „Das kann z.B. einem Allgemeinmediziner helfen, der selten mit der Krankheit konfrontiert ist, eine erste Verdachtsdiagnose zu stellen“, sagt der Computer Vision-Experte.

Das unvoreingenommene Programm

Deep Learning bringe aber freilich weitere Möglichkeiten. Hier bestünden zwei Ansätze: „Supervised Learning“ und „Unsupervised Learning“. „Während ich beim ‚Supervised Learning‘ gewisse Informationen einfüttere – in unserem Beispiel etwa die bereits als Hautkrebs klassifizierte Bilder, die dem Programm als Grundlage dienen, ist es beim ‚Unsupervised Learning‘ quasi unvoreingenommen und bildet selbstständig Cluster“, erklärt Singh. Dieser Zugang könne unerwartete Zusammenhänge und damit neue Erkenntnisse ans Tageslicht bringen.

Big Data als Fluch und Segen

Voraussetzung für das Gelingen sei gerade beim „Unsupervised Learning“, aber auch in den anderen „Data Science“-Bereichen, das Vorhandensein ausreichender Datenmengen. Und diese können sich für Data Scientists als Fluch und Segen zugleich erweisen. „Wir sprechen hier von Big Data. Je nachdem, um was für Daten es sich handelt, können Datensets aber auch zu groß werden, um sie bearbeiten zu können. Gerade bei Bildern und Videos ist man sehr schnell im Terrabyte-Bereich und muss dann gegebenenfalls ein kleineres Datenset heranziehen oder an großen Computing-Clustern arbeiten“, erklärt Ronald Luc.

Data Scientist – „ein Blick“ für Daten

Und das ist nicht die einzige Herausforderung, mit der man als Data Scientist konfrontiert ist. „Kunden haben häufig zwar große Mengen an Daten, wissen aber gar nicht, was sie damit anfangen können und können daher auch keine Ziele für die Analyse definieren“, erzählt Viktor Sandner. In anderen Fällen würden die Ziele nicht mit den verfügbaren Daten zusammenpassen. „Das kann man aber sehr schnell herausfinden. Nach einiger Zeit hat man einen Blick dafür und sieht sofort, ob das Unterfangen erfolgsversprechend ist“.

„Ich lese jeden Tag zum Frühstück ein Paper“

Ausruhen könne man sich darauf aber nicht. Denn die rapide Entwicklung in dem Bereich erfordere ständige Anpassung. „Die gesamte Technologie, die wir verwenden, ändert sich alle paar Monate“, sagt Sanchit Singh. Für Ronald Luc ergibt sich dadurch eine besondere Morgen-Routine: „Ich lese jeden Tag zum Frühstück ein Paper“.
Redaktionstipps
Deine ungelesenen Artikel:
21.10.2026

Grazer Deep-Tech-Spin-off DiLT Analytics schließt siebenstellige Finanzierungsrunde ab

Das Grazer TU-Spinoff holt den Deep-Tech-Fonds Noctua Science Ventures als Investor an Bord und erhält zusätzlich eine Förderung aus dem Programm aws Seedfinancing – Deep Tech. Das Kapital soll in den Teamaufbau und in den Rollout der Diagnosesoftware FaciliMind fließen.
/artikel/grazer-deep-tech-spin-off-dilt-analytics-schliesst-siebenstellige-finanzierungsrunde-ab
DiLT Analytics
© DiLT Analytics

DiLT Analytics hat eine siebenstellige Finanzierungsrunde abgeschlossen. Sie setzt sich aus einem Equity-Investment von Noctua Science Ventures und einer Förderung der Austria Wirtschaftsservice (aws) im Rahmen des Programms Seedfinancing – Deep Tech zusammen. Mit dem Geld möchte das 2021 gegründete Spinoff der TU Graz sein Team ausbauen und FaciliMind, seine Software zur automatisierten Fehlerdiagnose in Heizungs-, Lüftungs- und Klimaanlagen, zu weiteren Betreibern großer Gebäudeportfolios bringen

DiLT Analytics: „Substanziell wachsen“

Noctua Science Ventures ist ein Wiener Deep-Tech-Fonds und ein Joint Venture von Speedinvest und den Technischen Universitäten Österreichs. Der Fonds investiert gezielt in Ausgründungen, deren Produkt auf langjähriger Forschung beruht.

„Die aws-Förderung ergänzt das Investment und ist auf genau diese Phase zugeschnitten: den Schritt von einer erprobten Technologie zu einem Produkt, das sich über viele Standorte hinweg ausrollen lässt“, heißt es per Aussendung. Um im Sinne des Programms aws Seedfinancing – Deep Tech als Deep Tech zu gelten, muss das Vorhaben auf einer „anspruchsvollen technologischen und wissenschaftlichen Herausforderung“ basieren und einen klaren Technologiesprung gegenüber bestehenden Lösungen oder rein inkrementellen Weiterentwicklungen ermöglichen.

„Mit Noctua Science Ventures haben wir einen Partner gefunden, der beides kennt: die technischen Herausforderungen eines Deep-Tech-Produkts und den Weg in die Kommerzialisierung. Für ein junges Spinoff ist das der Best Case. Dass parallel auch die aws-Förderung zugesagt wurde, bestätigt uns, dass FaciliMind und unser Team auf dem richtigen Weg sind. Jetzt geht es darum, substanziell zu wachsen“, sagt Theresa Kohl, CEO von DiLT Analytics.

Philipp Stangl, Managing Director von Noctua Science Ventures, ergänzt: „Von unseren vielen Gesprächspartnern erhielten wir ein sehr einheitliches Bild zu DiLT: ein glaubwürdiger, technisch differenzierter Ansatz, umgesetzt von einem Team, mit dem Immobilienprofis gerne zusammenarbeiten. Genau diese Kombination aus Forschungsvorsprung und starker Kundenorientierung ist es, wonach wir in der Pre-Seed-Phase suchen.“

2021 gegründet

DiLT Analytics wurde Ende 2021 von Franz Wotawa und Gerald Schweiger als Spinoff des Instituts für Softwaretechnologie der TU Graz gegründet und ging aus der Forschungsgruppe „Intelligent Systems“ hervor. Erstes größeres Projekt war „Inframonitor“, eine herstellerunabhängige IoT-Datenplattform für den Campus Inffeldgasse der TU Graz.

Seither ist DiLT an mehr als 20 Forschungsprojekten mit über 15 Partnern beteiligt, einige davon FFG-gefördert und gemeinsam mit österreichischen und europäischen Universitäten. Die Ergebnisse fließen über den Forschungszweig DiLT Research direkt in die Produktentwicklung. Geführt wird das Unternehmen heute von Theresa Kohl (CEO), Christopher Gray (Business Development & Strategy), Thomas Hirsch (CTO), Reinhard Pertschy (CPO) und Thomas Schwengler (Head of Software).

Die entwickelte Software FaciliMind analysiert Betriebsdaten von Heizungs-, Lüftungs- und Klimaanlagen, erkennt dabei versteckte Fehler und Optimierungspotenziale und liefert Technikteams eine nach Dringlichkeit sortierte Maßnahmenliste, so der Claim. Die Software von DiLT Analytics arbeitet herstellerunabhängig und lässt sich über ein einzelnes Gerät an die bestehende Gebäudeleittechnik anbinden. Dank eines knowledgegraphbasierten Softwarestacks soll sie das digitale Abbild komplexer Anlagen weitgehend automatisiert innerhalb weniger Tage statt monatelanger Handarbeit erstellen können. Zielgruppe sind Betreiber großer Gebäudeportfolios, etwa in der öffentlichen Hand, an Flughäfen sowie in Industrie und Gesundheitswesen.

DiLT Analytics erhielt Preise

Zu den Kunden zählen u.a. die Technischen Universitäten Graz und Wien, Bundesimmobiliengesellschaft (BIG), IG Immobilien Management GmbH und Industriekunden. 2025 wurde DiLT Analytics mit dem DREA Award und dem ÖGUT Umweltpreis ausgezeichnet. Und ist seit September 2026 nach ISO 27001 zertifiziert.

„Wissen über Anlagenbetrieb soll im Unternehmen bleiben“

Neben der Verstärkung des Teams und dem geplanten Rollout möchte DiLT Analytics künftig ein Übersetzungswerkzeug für den BACtwin-Standard als Open Source veröffentlichen und die Diagnose künftig auf weitere Technologien wie Wärmepumpen, Photovoltaik und Batteriespeicher ausweiten

„Ein Gebäudeportfolio überdauert seine Dienstleister und oft auch seine erfahrensten Mitarbeitenden“, sagt Kohl. „Unser Ziel ist, dass das Wissen über den Anlagenbetrieb im Unternehmen bleibt und dass Entscheidungen auf verifizierter Datengrundlage statt auf Bauchgefühl und Erinnerung beruhen.“

Toll dass du so interessiert bist!
Hinterlasse uns bitte ein Feedback über den Button am linken Bildschirmrand.
Und klicke hier um die ganze Welt von der brutkasten zu entdecken.

brutkasten Newsletter

Aktuelle Nachrichten zu Startups, den neuesten Innovationen und politischen Entscheidungen zur Digitalisierung direkt in dein Postfach. Wähle aus unserer breiten Palette an Newslettern den passenden für dich.

Montag, Mittwoch und Freitag

AI Summaries

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Welche gesellschaftspolitischen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Welche wirtschaftlichen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Innovationsmanager:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Investor:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Politiker:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Was könnte das Bigger Picture von den Inhalten dieses Artikels sein?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Wer sind die relevantesten Personen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?

AI Kontextualisierung

Wer sind die relevantesten Organisationen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Was macht eigentlich ein Data Scientist?