25.01.2023

So diskriminiert KI: ChatGPT entfacht Debatte neu

Jasmin Reisinger und Gabriele Bolek-Fügl erklären, wie Diskriminierung in der Künstlichen Intelligenz und in der KI-Branche funktionieren und was man dagegen tun könnte. Der Fall ChatGPT hat die Debatte neu entfacht.
/artikel/so-diskriminiert-ki-chatgpt-entfacht-debatte-neu
Gabriele Bolek-Fügl und Jasmin Reisinger (Women in AI Austria) sprechen über ChatGPT und Ethik in der KI © Bolek-Fügl; Reisinger; Parradee/AdobeStock

Die Kritik um ChatGPT und die Möglichkeit, rassistische oder sexistische Statements im Zuge der Nutzung zu erhalten, gibt es bereits länger. Mittlerweile hat sich die Debatte über die ethischen Aspekte der Künstlichen Intelligenz (KI) erweitert. Der Chatbot wurde soweit trainiert, dass scheinbar keine diskriminierenden Statements mehr vorkommen. Die erfolgreiche Behebung hat seinen Preis. Wie Recherchen des Time Magazins zeigen, hat die hinter ChatGPT stehende Firma OpenAI Textausschnitte an das Trainingsdatenunternehmen Sama gesendet, um die KI zu trainieren. Klickarbeiter:innen der Sama-Außenstelle in Kenia wurden dafür laut Time Magazin nicht nur mit unter zwei Dollar die Stunde für ihre Arbeit bezahlt, sondern waren mit teils traumatisierenden Inhalten konfrontiert. Um eine KI manuell zu trainieren, braucht es nämlich Menschen, die die toxischen Inhalte als solche klassifizieren und der KI übermitteln. 

Solche Skandale werfen Fragen auf: Wie können einer KI diskriminierende, sexistische und rassistische Inhalte abtrainiert werden, ohne zugleich in der realen Welt prekäre Arbeitsbedingungen zu bestärken? Im gemeinnützigen Verein “Women in Artificial Intelligence Austria” setzen sich mehrere AI-Expertinnen nicht nur mit den technologischen Aspekten, sondern auch mit der Geschlechterlücke in der Künstlichen Intelligenz auseinander. Damit widmen sie sich einer speziellen Form der Diskriminierung in der KI. Im brutkasten-Gespräch bewerten Jasmin Reisinger und Gabriele Bolek-Fügl von “Women in AI” den Fall ChatGPT und erklären die technologischen Hintergründe und was man in der Branche beachten muss, sodass gerechte Rahmenbedingungen herrschen – sowohl in der Technologie, als auch in der Realität.


Was ist Diskriminierung in der AI und wie findet sie aktuell statt?

Jasmin und Gabriele: Eine Künstliche Intelligenz lernt selbständig auf Basis von sehr vielen Datensätzen, die der Mensch bereitstellt. Diese Datensätze bilden entweder eine Momentaufnahme ab, die die bisherige Realität darstellt – inklusive der Diskriminierung von einzelnen Menschengruppen. Oder sie bilden eine Situation ab, von der umfassende Datensätze vorhanden sind. Bei zweiterem bedeutet dies, dass selten eine ausgewogene Bandbreite der Menschen in den Daten vorhanden ist. Außerdem werden die KI-Modelle von einer homogenen Gruppe von Programmierer:innen erstellt. Auch das ist eine Quelle dafür, dass sich Vorurteile in den Ergebnissen von KI-Systemen widerspiegeln.

Diskriminierung im Kontext von KI bedeutet demnach, dass Interpretationsmuster vom Menschen übernommen werden können. So können negative Diskriminierungsstrukturen entstehen. Um dies zu vermeiden, müssen Trainingsdaten „bereinigt“ oder „ergänzt“ werden und das ist bei Millionen von Datensätzen keine einfache Aufgabe. Vor dieser Herausforderung steht aktuell OpenAI und deren Chatbot “ChatGPT”, der für sein Können bestaunt und für seine Limitierungen kritisiert wird.

Wie beobachtet bzw. bewertet ihr diesen Sachverhalt rund um OpenAI und deren Umgang mit externen Angestellten?

Jasmin: Der Time-Artikel zu OpenAI hat bestimmte Vorgänge im Hintergrund sehr detailliert beleuchtet, die der breiten Öffentlichkeit vorher unbekannt waren. Wie bereits erwähnt ist die Bereinigung von riesigen Datensätzen eine Herausforderung, zu der es oft (noch) keine einfache Lösung gibt. Dabei sind zwei Perspektiven zu beachten: Einerseits sollte die KI-Industrie bei heiklen Datensätzen nicht auf einfache Lösungen zurückgreifen, die auf der Ausbeutung billiger Arbeitskräfte beruhen, um schnellen technologischen Fortschritt zu erreichen. Andererseits ist die Involvierung von diversen Personengruppen mit unterschiedlichen Lebensrealitäten zu begrüßen, da sie für ausgewogenere KI-Modelle stehen können.

Gabriele: Die Reaktion der Öffentlichkeit wird OpenAI langfristig dazu zwingen, ethisch unbedenkliche Wege zu finden, wie sie ihre Technologie weiterentwickeln können. Ethische Beurteilungen unterliegen immer einem gesellschaftlichen Diskurs und da stehen wir noch ganz am Anfang. Es ist jedenfalls zu begrüßen, dass die Daten von ChatGPT nach unterschiedlichen Kriterien beurteilt und bereinigt wurden. KI-Systeme anderer Hersteller mussten aufgrund von nicht ausreichend bereinigten Daten bald wieder deaktiviert werden. Ethik ist nicht einfach da. Ethische KI-Systeme bedeuten die Abbildung der gesellschaftlichen Meinung zu einem bestimmten Zeitpunkt, und diese kann sich rasch ändern. Und es bedeutet viel Arbeit, diese Meinung in tausenden Datensätzen abzubilden.

Jasmin: Ich möchte an dieser Stelle jedoch betonen, dass nicht alle KI-Systeme mit Hochrisiko-Datensätzen gefüttert werden (müssen). Die Qualitätssicherung in der Glasindustrie z.B. ist weit weg von Themen wie Rassismus oder Sexismus, und verbessert tatsächlich die Arbeitsprozesse für Arbeitnehmer:innen. Den Fall OpenAI werden wir weiterhin beobachten.

Viele Menschen vergessen bei Künstlicher Intelligenz die manuellen Aspekte – also die Content Moderation hinter der Menschen stehen, die ungefiltert mit sämtlichen Daten konfrontiert werden. Teilweise kann das auch zu einer psychischen Belastung für Arbeitnehmer:inenn führen. Wie kann man sich diese manuellen Aspekte vorstellen?

Jasmin: Um Datensätze als Basis für KI-Systeme nutzen zu können, müssen diese einem „Labeling“ unterzogen werden. Der Mensch kennzeichnet dann z.B. die Merkmale einer Katze, damit die KI lernt, woran sie eine Katze erkennen oder von einem Hund unterscheiden kann.

Bei Millionen von Datensätzen muss z.B. im Falle von OpenAI gekennzeichnet werden, welche Daten diskriminierend, rassistisch, sexistisch usw. sind, um qualitativ hochwertige, wertfreie Datensätze zu erzielen. Erst dann kann die KI „gute“ Ergebnisse liefern. Vor- oder Nachteile gibt es in dem Sinne nicht. Der steigende Bedarf an „Data Labeling“ wird viele Unternehmen lediglich vor eine Herausforderung stellen.

Gabriele: Dass potentiell traumatisierende Informationen von Menschen angesehen werden müssen, um ein Daten Labeling für KI durchzuführen, ist der Realität geschuldet. Diese Daten wurden aus einem bestimmten Grund von Menschen erstellt. Dieser war nicht, als Trainingsdaten für eine KI herangezogen zu werden, sondern Angst, Betroffenheit oder Ähnliches bei anderen Personen zu erzeugen.

OpenAI ist nicht das erste und vermutlich nicht das letzte Unternehmen, bei dem so etwas vorkommt. Gerade in Anbetracht der Tatsache, dass wir jetzt auf einen AI-Hype blicken: Wie muss sich die AI-Branche verändern, damit solche Arbeitsbedingungen aufgehalten werden?

Gabriele: Wollen wir ethische KI-Systeme, so muss vorher ein gesellschaftlicher Diskurs zu den ethischen Werten stattfinden. Dann kann versucht werden, diese in den KI-Modellen abzubilden. Bekannt ist das Beispiel, ob ein selbstfahrendes Auto eher einen 80-jährigen Mann bei einer unausweichlichen Kollision verletzen soll oder die Mutter mit Kinderwagen.

Die Auslagerung des “Data Labeling” in andere Länder mit billigeren Kostenstrukturen und Lohn hat auch mehrere Aspekte. Aus Diversitätsgründen ist es einerseits zu begrüßen, außerdem werden so auch Arbeitsplätze mit für die Länder meist gutem Lohn geschaffen. Andererseits werden häufig jene Sachverhalte ausgelagert, die man den eigenen Angestellten nicht zumuten möchte. Das ist ethisch sicher bedenklich.

Da Millionen von Datensätzen gelabelt werden müssen, sind die KI-Unternehmen darauf angewiesen, in andere Länder auszuweichen, um die Kosten für die KI-Systeme nicht immens hoch werden zu lassen und die Arbeit parallel zur Entwicklung durchzuführen. Kosten KI-Systeme letztendlich zu viel, werden sie von nur wenigen Kund:innen genutzt. Es verzerrt den Wettbewerb noch mehr, wenn diese Methodik nur einem kleinen Benutzerkreis zur Verfügung steht, der sich hohe Kosten leisten kann.

Jasmin: Zusätzlich ist noch der geografische Aspekt zu beachten. In Europa herrscht im Gegensatz zu den USA ein Bestreben nach regulierten, vertrauenswürdigen KI-Systemen. Hier wird durchaus betont, dass sowohl in technischer als auch gesellschaftlicher Hinsicht, kein Schaden angerichtet, sondern ausschließlich positive wirtschaftliche und gesellschaftliche Beiträge geleistet werden sollen. Ein konkreter Rechtsrahmen fehlt zwar auch hier noch, aber die Richtung stimmt. Langfristig werden Länder wie die USA an Regulierungen und Leitlinien feilen müssen, wenn sie das Vertrauen der Benutzer:innen erlangen bzw. behalten wollen.

Deine ungelesenen Artikel:
15.09.2026

Ablatic AI: Linzer LLM Talos spielt ohne VC-Kapital in einer Liga mit internationalen KI-Playern

Das nun gelaunchte Large Language Model (LLM) Talos des Linzer Startups Ablatic AI kann sich in mehreren Benchmarks mit den internationalen KI-Giganten messen. Co-Founder und CEO Florian Zimmermann erklärte uns, wie das ohne VC-Kapital möglich ist und wie man nun den Markt erobern will.
/artikel/ablatic-ai-linzer-llm-talos-spielt-ohne-vc-kapital-in-einer-liga-mit-internationalen-ki-playern
15.09.2026

Ablatic AI: Linzer LLM Talos spielt ohne VC-Kapital in einer Liga mit internationalen KI-Playern

Das nun gelaunchte Large Language Model (LLM) Talos des Linzer Startups Ablatic AI kann sich in mehreren Benchmarks mit den internationalen KI-Giganten messen. Co-Founder und CEO Florian Zimmermann erklärte uns, wie das ohne VC-Kapital möglich ist und wie man nun den Markt erobern will.
/artikel/ablatic-ai-linzer-llm-talos-spielt-ohne-vc-kapital-in-einer-liga-mit-internationalen-ki-playern
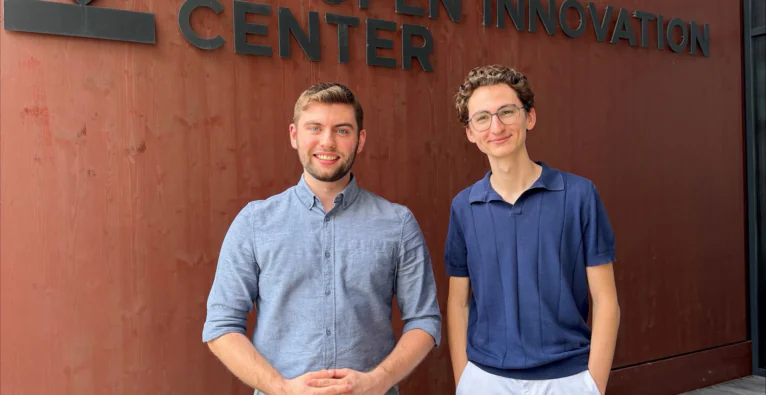
Die Ablatic-AI-Gründer vl. Florian Zimmermann (CEO) und Julian Mauerkirchner (CTO) | (c) Ablatic AI

Wieder einmal ist es Linz. Die Stahlstadt mausert sich immer mehr zu Österreichs KI-Hauptstadt und auch eines der bislang sicher ambitioniertesten Startups in dem Bereich kommt von dort: Ablatic AI. Mit Talos wagt es sich über die Herausforderung schlechthin in der KI-Welt: ein eigenes Large Language Model (LLM) – brutkasten berichtete bereits.

Bei einer Benchmark vor Sol von OpenAI

Nun erfolgte der offizielle Launch und Ablatic gab erste Benchmark-Vergleiche aus (siehe Tabelle unten). An Claude Opus 5 kommt man demnach noch in keiner Kategorie ganz heran, in mehreren aber ziemlich nahe. DeepSeek V4 kann man dagegen gleich bei drei Werten schlagen, Qwen3.8 von Alibaba bei zwei und OpenAIs Flagship-Modell GPT-5.6 Sol immerhin bei einem, konkret der exakten Befolgung schriftlicher Anweisungen (IFBench). Unterm Strich spielt das Linzer LLM also in den vorgelegten Benchmarks in der internationalen Top-Liga mit.

„Es kann ja nicht sein, dass es in Europa nur Mistral gibt“

Aber warum überhaupt noch ein weiteres LLM? „Julian [Anm. Mauerkirchner] und ich kennen uns schon seit der Schule. Später haben wir als Unternehmer damit gestartet, Legacy-ERP-Systeme zu erneuern. Dabei sind wir auf ein Problem gestoßen: Wir konnten dafür aus Daten-Gründen keine US-KI-Systeme nutzen“, erzählt CEO Florian Zimmermann, der Ablatic AI gemeinsam mit Julian Mauerkirchner (CTO) gegründet hat, im Gespräch mit brutkasten. Man habe nur Mistral aus Frankreich oder Open-Source-Modelle verwenden können. „Mistral war für den Zweck aber nicht passend und unser Business Case bald tot“.

Mit dem Entschluss, eine neue Idee zu verfolgen, sei daher auch eine neue Motivation einher gegangen: „Es kann ja nicht sein, dass es in Europa nur Mistral gibt“, so Zimmermann. Man habe sich danach mit der Johannes Kepler Universität Linz (JKU) kurzgeschlossen und sei darüber auch zur AI Factory Austria AI:AT gekommen, wo man wiederum im Rahmen des EuroHPC-Programms europäische Hochleistungsrechenressourcen nutzt, um das Modell zu trainieren. „Ohne diese EU-Ressourcen würde es kostentechnisch überhaupt nicht gehen“, sagt Zimmermann.

Öffentliche Forschungsergebnisse statt eigenes Riesen-Research-Team

Doch auch mit diesen Ressourcen – wie lässt sich ein konkurrenzfähiges LLM mit einem kleinen Team und bislang gänzlich ohne VC-Kapital umsetzen? Schließlich beschäftigen die globalen KI-Player, mit denen sich Ablatic misst, riesige Teams. Mistral etwa ist mit seiner kürzlich kommuniziert Drei-Milliarden-Euro-Finanzierungsrunde im Vergleich zu Anthropic und OpenAI nach wie vor ein kleiner Fisch (brutkasten analysierte).

„Wir können kein 200-köpfiges Research-Team finanzieren und gleich von 0 auf 100 gehen, also greifen wir auf Bestehendes zurück“, erklärt der Gründer. Konkret verwende man einerseits Open-Source-Layer und code sie auf die eigenen Bedürfnisse um. Andererseits nutze man die neuesten Forschungsergebnisse von Universitäten wie dem MIT oder Stanford, die laufend über die Plattform arXiv veröffentlicht werden. „Wir orientieren uns an der Frontier-Forschung. Wir analysieren die Paper, legen die Erkenntnisse auf unsere Architektur um und testen es durch. Vieles davon funktioniert nicht, aber alles was funktioniert, bringt uns weiter“, so Zimmermann.

Mehr als 100 B2B-Testkunden – viele konvertieren gleich zum Launch

Die Beta-Version wurde nun bereits seit einiger Zeit mit mehr als 100 Unternehmen getestet – Ablatic konzentriert sich nämlich vorerst klar auf den B2B-Markt. Man habe für diese Tests schnell auch größere Unternehmen und Konzerne gewonnen. „Ich bin dafür wochenlang gesessen, habe Leute angeschrieben und einen Call nach dem anderen gemacht“, räumt Zimmermann ein. Dass man ein eigenes LLM und nicht nur eine Oberfläche baue, sei dabei zum entscheidenden Bonus geworden. „Und dass wir von der JKU kommen und im EuroHPC-Programm sind, hat unsere Glaubwürdigkeit enorm gesteigert“, sagt der Gründer.

Jetzt zum Launch würden viele der Testkunden bereits zu regulären Nutzern konvertieren, viele weitere noch die Testphase abschließen, mit dem Vorhaben, das dann auch zu tun, verrät Zimmermann. „Wir werden nicht 100 Prozent, aber einen Großteil konvertieren können“, ist er sicher. Punkten will Ablatic dabei nicht nur mit der europäischen Herkunft – Stichwort: Digitale Souveränität – sondern auch mit dem Pricing. „Wir haben eine relativ effiziente Architektur. Wir können kostengünstig hosten und das an die Kunden weitergeben“, so der CEO. Dass der offizielle Launch genau jetzt erfolgt, hat vor allem mit dem Gründungsprozess zu tun, der länger dauerte, als erhofft. „Ich gründe nie wieder im Sommer ein Unternehmen“, sagt der Gründer lachend.

Investment geplant: „Das Ziel ist definitiv, keine kleine Bude zu bleiben“

Und wie geht es weiter? „Wir wollen zuerst im DACH-Raum Fuß fassen und ohne große weitere Standorte skalieren. Dann wollen wir es auf Europa hochziehen“, erläutert Zimmermann. Auf Dauer werde dabei auch die Aufnahme von VC-Kapital relevant, vor allem wenn es darum gehe, die nächste Modell-Version herauszubringen. „Dann ist es wichtig, dass man schnell skaliert und iteriert. Wir sind stolz darauf, dass wir ein Modell ohne VC-Kapital trainiert haben. Wir haben gezeigt, dass auch so Großes möglich ist. Aber langfristig ist es völlig logisch, dass wir Kapital aufnehmen müssen“, sagt der Gründer.

Und es seien bereits mehrere Investoren aktiv auf das Team zugekommen, mit einigen befinde man sich schon in Gesprächen. „Das Ziel ist definitiv, keine kleine Bude zu bleiben, sondern eine größere Firma zu werden. Wir wollen jedenfalls nicht in Vergessenheit geraten“, so Zimmermann. Und der Zeitpunkt sei angesichts der Souveränitätsdebatte gut.


Benchmark-Vergleichstabelle

Anmerkungen zur Tabelle:

  • Fette Zahlen: Höchster Wert in der jeweiligen Zeile unter den Vergleichsmodellen.
  • „text-only“: Das Modell verarbeitet keine Bilder/visuellen Dokumente, weshalb OmniDocBench nicht anwendbar ist.
  • „–“: Kein veröffentlichter Wert vorhanden.

Kurzerklärungen der Benchmarks

  • Agents‘ Last Exam (UC Berkeley): Prüft langwierige, echte Arbeitsaufgaben an einem Computer (Terminal und Bildschirm zusammen), bewertet anhand des fertigen Gesamtergebnisses.
  • AutomationBench (Zapier): Testet 600 Business-Workflows über 47 simulierte Unternehmens-Softwaretools hinweg, die vollständig durchgehend ausgeführt werden müssen.
  • Toolathlon: Bewertet das Erledigen von Aufgaben in echter Büro-Software (z. B. E-Mail, Kalender, Tabellenkalkulationen und GitHub) über deren direkte Schnittstellen.
  • BrowseComp (OpenAI): Stellt schwierige Fragen, deren Antworten über das gesamte Internet verstreut liegen und durch selbstständiges Surfen recherchiert werden müssen.
  • DeepSWE v1.1 (Datacurve): Misst das eigenständige Beheben echter Softwareprobleme (Bugs) in bestehenden Quellcode-Sammlungen. Hinweis: Talos-1 wurde hierfür nicht optimiert und liegt 22 Punkte hinter der Spitze zurück.
  • OmniDocBench: Bewertet das fehlerfreie Lesen und Verstehen echter Dokumente inklusive visueller Layouts, Tabellen und mathematischer Formeln.
  • IFBench: Prüft die exakte Einhaltung von schriftlich vorgegebenen Anweisungen und Formatierungsregeln.
Toll dass du so interessiert bist!
Hinterlasse uns bitte ein Feedback über den Button am linken Bildschirmrand.
Und klicke hier um die ganze Welt von der brutkasten zu entdecken.

brutkasten Newsletter

Aktuelle Nachrichten zu Startups, den neuesten Innovationen und politischen Entscheidungen zur Digitalisierung direkt in dein Postfach. Wähle aus unserer breiten Palette an Newslettern den passenden für dich.

Montag, Mittwoch und Freitag

AI Summaries

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Welche gesellschaftspolitischen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Welche wirtschaftlichen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Innovationsmanager:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Investor:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Politiker:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Was könnte das Bigger Picture von den Inhalten dieses Artikels sein?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Wer sind die relevantesten Personen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu

AI Kontextualisierung

Wer sind die relevantesten Organisationen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

So diskriminiert KI: ChatGPT entfacht Debatte neu