20.12.2023

KI-Experte Klambauer über Large Language Models: „Brauchen jetzt neue Ideen“

Interview. Steuern wir auf eine Artificial General Intelligence (AGI) zu - oder stoßen die aktuell populären Ansätze bei künstlicher Intelligenz (KI) bald an ihre Grenzen? KI-Forscher Günter Klambauer von der Johannes Kepler Universität Linz erläutert im brutkasten-Gespräch den aktuellen Stand - und wie es mit KI weitergehen könnte.
/artikel/klambauer-neue-ideen-sprachmodelle
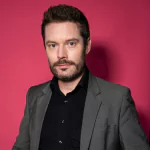
KI-Professor Günter Klambauer
Günter Klambauer | Foto: Johannes Kepler Universität Linz

Günter Klambauer ist assozierter Professor für künstliche Intelligenz an der Johannes Kepler Universität Linz. Im brutkasten-Interview erläutert er, wie die Fortschritte bei großen Sprachmodellen (Large Language Models – LLMs) aus technischer Sicht zu bewerten sind und welche Zukunftszenarien für künstliche Intelligenz überhaupt realisitisch sind.


brutkasten: Beruhen die aktuellen Fortschritte bei Large Language Models (LLMs) auf besseren Algorithmen oder doch eher auf stärkerer Rechenpower und höherer Skalierung?

Günter Klambauer: 2019 hat man herausgefunden, dass man einfach durch das bloße Größermachen von Modellen deutliche Verbesserungen erzielen kann. Diese Modelle sind sogenannte künstliche neuronale Netze und bei deren Entwicklung kann man einfach entscheiden, wie groß die sind. Man kann die größer machen, indem man einfach eine Zahl im Programm ändert. 

Für manche in der Forschung war das ein bisschen enttäuschend, denn bis dahin ist man davon ausgegangen, dass man dafür neue Algorithmen brauchen würde. Tatsächlich hat sich aber eben herausgestellt, dass sich die Modelle durch das bloße Größermachen verbessern. 

Das führt aber dazu, dass man mehr Rechenpower benötigt. Für die IT-Giganten wie Google, Facebook, Amazon oder OpenAI war das super. Die verfügen über große Rechenzentren und konnten ihre Modelle einfach immer größer und größer machen. 

Allerdings beruhen nicht alle Fortschritte nur auf Skalierung. Es hat schon auch die sogenannte Transformer-Technologie benötigt. Sie hat dazu geführt, dass Sprachmodelle eben nicht nur übersetzen, sondern auch generieren – basierend auf Texten oder Vervollständigen. Das ist, was wir als Generative Pre-Trained Transformers, als GPTs, kennen.

Welche Rolle spielen die Datensätze dabei?

Das ist die zweite Achse, man füttert die Modelle mit mehr Daten. Früher waren die Datensätze vergleichsweise klein – mit ein paar Milliarden Wörtern aus Wikipedia. Mittlerweile muss man sich das so vorstellen, dass der gesamte textuelle Teil des Internet für das Training verwendet wird – viele Terabytes an Daten. Die Modelle verbessern sich also aus zwei Richtungen: Größere Datensätze sind die eine, und die Modelle vergrößern ist die andere. Beides hilft. 

Wie lange kann man diese Sprachmodelle durch Skalierung weiter verbessern? Erreichen wir Grenzen der Skalierung?

Das weiß man jetzt noch nicht, aber ich glaube schon, dass wir jetzt an dem Punkt sind, an dem Hochskalierung nicht mehr so viel bringt wie früher. Ab jetzt brauchen wir neue Ideen für Sprachmodelle – und neue Technologien. 

Allerdings kann man es oft auch nicht mit Sicherheit sagen: Wenn man nicht zu den IT-Giants gehört, kann man das schwer überprüfen, wo wir gerade stehen. Ein Sprachmodell wie GPT-4 von OpenAI trainiert auf zehntausenden Grafikkarten gleichzeitig. Da gibt es in ganz Europa kein Rechenzentrum, das das durchrechnen könnte. 

Als OpenAI Ende November 2022 den Chatbot ChatGPT veröffentlicht hat, hat dies in der Öffentlichkeit für großes Aufsehen gesorgt. Wie war die Reaktion in der Wissenschaft?

Das war auch für die Wissenschaft erstaunlich. Ich war damals gerade auf einer wissenschaftlichen Konferenz. Dort sind die Leute herumgelaufen und haben ChatGPT am Handy ausprobiert und waren verblüfft. Natürlich haben wir seit 2014 den Trend gesehen, dass Sprachmodelle immer besser und besser wurden. 

Aber erstaunlich war auch, wie leicht zugänglich künstliche Intelligenz dadurch wurde. OpenAI hat dafür gesorgt, dass die Sprachmodelle sehr gut mit Menschen interagieren können. In der Forschung nennt man das “Human Alignment”. Das war etwas Neues. 

Das war übrigens auch ein zusätzlicher Trainingsschritt. ChatGPT hat nicht nur aus bestehenden Texten die Abfolge der Wörter gelernt, sondern es hat auch auf das sogenannte Reinforcement Learning with Human Feedback gesetzt. Es gab bei ChatGPT eine Phase, in der menschliche KI-Trainer dem Modell Feedback gegeben haben.

Dafür gab es allerdings auch Kritik, weil diese Trainer in Kenia rekrutiert wurden und für zwei Dollar in der Stunde gearbeitet haben. Aus wissenschaftlicher Sicht war dies aber ein zusätzlicher Trainingsschritt, über den die Modelle lernen konnten, die menschliche Intention besser zu verstehen.

Kritik gibt es auch der KI-Forschung generell – in Hinblick darauf, dass die Entwicklung außer Kontrolle geraten könnte und Risiken schlagend werden könnten, die jetzt noch nicht absehbar sind. Anfang des Jahres gab es sogar einen Aufruf, die KI-Forschung für ein halbes Jahr auszusetzen. Wie beurteilen Sie dies?

Dieser Call für ein Moratorium ist genau von jenen gekommen, die eigentlich selbst am meisten an dem Thema geforscht haben. Die haben dann auch keine Pause gemacht, sondern weiter Sprachmodelle trainiert.

Das Moratorium wurde wegen angeblich existenziellen Risiken gefordert – einem “Terminator”-Szenario, in dem eine KI die Weltherrschaft übernimmt oder die Menschheit auslöscht. Aber das lenkt einerseits von tatsächlich existenziellen Problemen ab – wie dem Klimawandel oder Atombomben. Andererseits lenkt es auch von den wirklichen Problemen ab, die mit den KI-Systemen schon heute bestehen: Es kommt zu unterschiedlichen Verzerrungen – etwa kann es sein, dass Modelle Frauen schlechter behandeln oder Vorurteile gegenüber bestimmten Bevölkerungsgruppen übernehmen, weil diese in Texten im Internet, anhand derer sie trainiert wurden, enthalten waren. 

Für KI-Systeme legt man außerdem immer Ziele fest – beispielsweise, dass sie eine gute Wortabfolge geben. Wenn Sprachmodelle mit “I am as an AI Agent” antworten, verstärkt das unsere Tendenz zum Anthropomorphismus, also dass wir Dingen menschliche Eigenschaften zuschreiben.

Durch Filme wie “Terminator” kommt es zu dieser Idee, dass KI-Systeme eigene Ziele haben und den Menschen möglicherweise unterwerfen wollen – weil eben Menschen über anderen Menschen herrschen wollen. Ein KI-System will das aber gar nicht. “Intelligenz” an sich bedeutet überhaupt nicht, dass man über andere herrschen möchte – das ist auch wieder ein Anthropomorphismus. 

Für KI-Systeme geben wir die Ziele vor – eben für ein Sprachmodell, dass sie eine Wortfolge gut vorhersagt. Hier gibt es natürlich das Risiko des Missbrauchs – etwa dass so ein System eingesetzt wird, um Fake News zu erzeugen. Da ist ein tatsächliches Problem, da ist aber wieder der Mensch dahinter. Es ist nicht das Ziel des KI-Systems selbst, Fake News zu erzeugen.

Ist das Konzept einer Artificial General Intelligence (AGI) für Sie damit in den Bereich Science Fiction einzuordnen – oder ist eine solche doch ein Szenario, das in den nächsten Jahrzehnten eintreten könnte?

Ja, ich glaube, dass das ein Science-Fiction-Konzept ist, das sich wieder sehr an dem Konzept menschlicher Intelligenz anlehnt. Wenn KIs besser werden, bezieht sich das immer nur auf bestimmte Bereiche. In der Bilderkennung haben KIs menschliche Qualität schon erreicht. Teilweise ist es sogar so, dass es uns als Menschen bei Bildern, auf denen viele ähnliche Dinge sind, schwer gefällt, irgendwas zu erkennen. Für eine KI ist das dagegen einfach.

Es gibt Dinge, die für Menschen extrem einfach sind und für eine KI wahnsinnig schwer und das auch noch lange bleiben werden. Das betrifft zum Beispiel motorische  Fähigkeiten – sehen Sie sich einmal an, wenn ein Roboter etwas aufheben muss, das am Boden liegt. 

Dass sich eine KI immer weiterentwickelt und dann exakt die menschliche Intelligenz erreicht – das wird so nicht ablaufen. Es wird zuerst Zwischenstufen geben, aber nicht den einen Moment, an dem man sagt, jetzt ist eine AGI erreicht oder nicht. In manchen Bereichen, wie zum Beispiel Bilderkennung oder Schach oder Go spielen, ist KI sogar dem Menschen schon überlegen.

Ist es somit aus Ihrer Sicht illusorisch, wenn davon gesprochen wird, dass künstliche Intelligenz irgendwann ein Bewusstsein entwickeln könnte?

Wenn Sie am Computer zwei Matrizen multiplizieren, sagt niemand, dass ein Ergebnis ein leichtes Bewusstsein habe. Genau das ist, was jetzt passiert. In einem neuronalen Netz werden sehr viele Matrix-Multiplikationen vorgenommen. Aber dass das Modell deswegen ein Bewusstsein entwickeln soll, ist meiner Meinung nach ein starker Anthropomorphismus.

Wenn man mit ChatGPT interagiert, erhält man häufig Antworten, die mit der Phrase „As an AI Agent,…“ eingeleitet werden. Das personifiziert sehr stark und versucht uns bis zu einem gewissen Grad glauben zu machen, dass wir wirklich mit einer Person interagieren. Ich hätte es daher bevorzugt, wenn ChatGPT in solchen Fällen „The Large Language Model…“ antworten würde. 

Wenn die gängigen aktuellen KI-Modelle nur mehr von den Tech-Giganten betrieben werden können, weil nur diese die notwendige Rechenpower haben – bedeutet dies, dass künftig einige wenige Large Language Models den Markt dominieren werden und diese auf alle möglichen Use Cases angewendet werden? Oder ist zu erwarten, dass Unternehmen eigene LLMs für spezifische Fälle trainieren und sich ebenfalls damit etablieren können? 

Das ist eine wirklich entscheidende Frage, über die ich mir auch schon viele Gedanken gemacht habe. Ich denke, dass es darauf hinauslaufen wird, dass es kleine Anzahl von diesen Modellen geben wird. Die Entwicklung könnte hier ähnlich verlaufen wie bei Suchmaschinen. Auch hier gab es am Anfang viele und mittlerweile sind es nur mehr einige wenige. Ich würde schätzen, dass am Ende drei bis fünf LLMs übrig bleiben, die die Leute verwenden. 

Die Frage ist dann: Wer sind diese Anbieter? OpenAI ist definitiv dabei. Schön wäre aber, wenn man es in Europa schaffen würde, ein europäisches Sprachmodell zu bekommen, dass dann zu europäischer Infrastruktur wird, die von Unternehmen verwendet werden kann. Ein Startup könnte dann also sagen, ich nehme dieses europäische Sprachmodell und passe es für meinen Einsatzzweck an.

Müsste ein solches europäisches Modell öffentlich finanziert werden? 

Die Finanzierung könnte zum Beispiel zum Teil öffentlich geschehen und zum Teil über private Investoren, etwa in Form einer Public-Private-Partnership. Wichtig ist jedenfalls immer die Rechenkapazität, die man braucht, um ein großes Sprachmodell zu entwicklen. Zwar gibt es auch in Europa Rechenzentren mit ein paar tausend Grafikkarten, aber die sind aus kleineren Einheiten aufgebaut und erlauben es normalerweise nicht, ein großes Sprachmodell auf allen Grafikkarten gleichzeitig zu trainieren.

Deine ungelesenen Artikel:
15.09.2026

KI im Investmentprozess: Wie Viessmann sein Deal-Screening beschleunigt

Nach dem zwölf Milliarden Euro schweren Verkauf des Heizungsgeschäfts an Carrier investiert die Viessmann Generations Group mittlerweile langfristig in eine breit aufgestellte Unternehmensgruppe. Nun baut das Familienunternehmen gemeinsam mit iteratec ein Multi-Agenten-System, das die Qualität von Investmententscheidungen maßgeblich verbessern soll: Alexander Pöllmann, Director IT & Digital von Viessmann, und Michael Maier, Director Austria von iteratec, geben im brutkasten-Gespräch einen Einblick.
/artikel/wie-viessmann-sein-deal-screening-mit-ki-umbaut
15.09.2026

KI im Investmentprozess: Wie Viessmann sein Deal-Screening beschleunigt

Nach dem zwölf Milliarden Euro schweren Verkauf des Heizungsgeschäfts an Carrier investiert die Viessmann Generations Group mittlerweile langfristig in eine breit aufgestellte Unternehmensgruppe. Nun baut das Familienunternehmen gemeinsam mit iteratec ein Multi-Agenten-System, das die Qualität von Investmententscheidungen maßgeblich verbessern soll: Alexander Pöllmann, Director IT & Digital von Viessmann, und Michael Maier, Director Austria von iteratec, geben im brutkasten-Gespräch einen Einblick.
/artikel/wie-viessmann-sein-deal-screening-mit-ki-umbaut
Alexander Pöllmann, Director IT & Digital bei der Viessmann Generations Group, und Michael Maier, Director Austria von iteratec (v.l.) | (c) iteratec / beigestellt

Es war eine der bemerkenswertesten Transformationen der deutschen Industrie: 2023 verkaufte Viessmann sein Kerngeschäft, die Klimasparte Viessmann Climate Solutions, für zwölf Milliarden Euro an den US-Konzern Carrier (brutkasten berichtete). Seit Anfang 2024 agiert das Familienunternehmen als Unternehmensgruppe, die aus Deutschland ein globales industrielles Beteiligungsportfolio steuert. Und dieses Kernteam soll nun KI-nativ werden: Gemeinsam mit dem Technologieunternehmen iteratec baut Viessmann ein Multi-Agenten-System, das die Mitarbeiter:innen zu “Buildern von Agenten” verändert.

Vom Heizungsbauer zum langfristigen Unternehmensentwickler  

Das reinvestierte Kapital floss vor allem in industrielle Mittelständler mit Fokus auf nachhaltige Energietransformation: von Grid-Infrastruktur über Fernwärme- und Kühlungslösungen bis zu Kühlhäusern. Dazu zählt etwa die isoplus-Gruppe, ein Hersteller von Nah- und Fernwärmeleitungen mit großen Standorten in Österreich. Über Minderheitsbeteiligungen ist Viessmann außerdem unter anderem an Encavis sowie am Software-Unternehmen AMCS beteiligt, das Emissionen in der Recycling- und Abfallwirtschaft reduzieren soll. 

Beim Thema KI unterscheidet Pöllmann klar zwischen zwei Ebenen: „Wenn wir auf unsere Partner schauen, ist der Kerntreiber klassischerweise Effizienz, also Use Cases entlang der Wertschöpfungskette, um Top- oder Bottom-Line-Potenziale einzusammeln. Auf Ebene des Viessmann-Teams schauen wir viel stärker auf Effektivität: Wie können wir noch bessere Investmententscheidungen treffen und unsere zentrale Entscheidungsqualität maßgeblich erhöhen?“ 

Deal-Screening statt Deal-Sourcing 

Genau das sei allerdings die schwierigere Disziplin, so Pöllmann: „Effizienz-Use-Cases sind aus unserer Sicht häufig leichter, als die Qualität zu erhöhen. KI tendiert in ihrer ursprünglichsten Natur dazu, lieber zu halluzinieren und ungenau zu sein, als eine sehr klare Antwort auf die Frage zu geben: Sollte ich dieses Investment tätigen oder lieber nicht? Welche Risiken habe ich noch nicht gesehen?“ Dies bedingt vor allem den ganzen Kontext einer Transaktion zu kennen. 

Konkret setzt das Multi-Agenten-System deshalb dort an, wo Präzision zählt: beim Screening. Es gehe nicht darum, Deals zu sourcen, betont Pöllmann, sondern den Prozess „Ist ein Deal für uns wirklich relevant?“ deutlich zu verkürzen. Ein Letter of Intent könne so viel schneller analysiert und daraus ein Investmentmemo gebaut werden, angereichert mit weiteren Quellen. 

Dass das Viessmann-Team das System selbst baut, statt auf eine Fertiglösung zu setzen, ist für Pöllmann eine Grundsatzentscheidung: „Wir wollen die Governance in der eigenen Hand haben, aber auch den Prozess, wie wir zu Entscheidungen kommen.“ Fertige KI-Finanzlösungen von der Stange würden der Organisation wenig bringen: „Das ist zwar alles nett und funktioniert auch schnell, aber nicht in der Qualität, wie wir sie erwarten.“ 

Jede:r Mitarbeiter:in wird zum „Builder“ 

Der vielleicht radikalste Teil des Ansatzes: Alle Mitarbeiter:innen der Viessmann Generations Group sollen befähigt werden, selbst KI-Agenten zu bauen. Der Prozess dahinter ist mehrstufig: Ein Intake-Agent nimmt die Idee auf und schärft sie, ein Specification-Agent zieht anschließend das nötige Fachwissen aus den Mitarbeiter:innen heraus und gibt erst ab einem bestimmten Confidence Score grünes Licht. Danach erstellt ein weiterer Agent, der sogenannte Agent-Builder, den fertigen KI-Kollegen. 

Gestartet wurde Ende Jänner mit einem „Hypersprint“, die ersten Prozessagenten gingen im Frühjahr live. „Es ist schon verrückt, was wir in der Zeit entwickelt haben“, sagt Pöllmann. Die größte Herausforderung sei dabei nicht die Technologie: „Die Herausforderung ist wirklich, das Wissen der Kolleg:innen “freizulegen” und die Leute, die verantwortlich sind, in die Verantwortung zu bekommen. So können wir dann gemeinsam den Input, den wir brauchen, identifizieren, um daraus vernünftige Agenten mit hoher Output-Qualität zu bauen.“ 

„Die Rolle des Menschen in der KI-Transformation wird maßgeblich“ 

Bei aller Automatisierung bleibt die Verantwortung beim Menschen, stellt Pöllmann klar: „Am Ende braucht es immer einen Verantwortlichen, und das kann nicht die Maschine sein. Dadurch wird vor allem die Rolle des Menschen in der KI-Transformation maßgeblich gestärkt.“ Wer einen Agenten verantwortet, müsse dessen Ergebnisse kontrollieren, ihn testen und etwa bei der Abkündigung eines KI-Modells nachjustieren. „Damit bekommt jeder in gewisser Weise eine Führungsaufgabe“, so Pöllmann. 

Um den Rollenwandel greifbar zu machen, ließ Viessmann die Mitarbeiter:innen ein eigenes „Role Canvas“ ausfüllen: Was bleibt an Verantwortung beim Menschen, wenn KI-Agenten übernehmen? Das habe viel Verständnis für die Transformation geschaffen, auch bei jenen, deren Berufsbild sich am stärksten verändert. Denn das klassische Profil eines Investmentbankers werde sich fundamental drehen, so Pöllmann. Die Betroffenen hätten das Thema allerdings „sehr gut aufgeschnappt und zeigen große Begeisterung dafür“. 

iteratec: „Die Unschärfe reduzieren“ 

Auf der Umsetzungsseite steht mit iteratec ein Software-Dienstleister, der seit 30 Jahren Individualsoftware entwickelt und sich zunehmend auf KI-Transformation fokussiert. „Unser eigenes Geschäft ändert sich aktuell selbst radikal aufgrund von KI“, sagt Michael Maier, Director Austria von iteratec. Das Unternehmen setzt Multi-Agenten-Projekte unter anderem bei Banken um und hat mit dem Recycling-Konzern Ragn-Sells ein neues Recyclingverfahren auf Basis KI-gestützter Materialanalysen entwickelt. Das Viessmann-Projekt sei „mitunter eines der spannendsten, das wir gerade machen dürfen“, so Maier: „Das nimmt sicher eine Vorreiterrolle ein.“ 

Die Kunst liege darin, schnell voranzukommen und trotzdem verlässliche Resultate zu liefern: „Du musst die Unschärfe so weit reduzieren, dass du dort, wo es wichtig ist, belastbare Ergebnisse hast, mit denen du arbeiten kannst“, sagt Maier. Viessmann kam über einen klassischen Anbieterauswahlprozess zu iteratec. Ausschlaggebend sei das Team gewesen, so Pöllmann: „Ein sehr professionell aufgestelltes Team mit High-End-AI-Capabilities. Die Entwickler sind fast AI-native unterwegs.” 

Toll dass du so interessiert bist!
Hinterlasse uns bitte ein Feedback über den Button am linken Bildschirmrand.
Und klicke hier um die ganze Welt von der brutkasten zu entdecken.

brutkasten Newsletter

Aktuelle Nachrichten zu Startups, den neuesten Innovationen und politischen Entscheidungen zur Digitalisierung direkt in dein Postfach. Wähle aus unserer breiten Palette an Newslettern den passenden für dich.

Montag, Mittwoch und Freitag

AI Summaries

KI-Experte Klambauer über Large Language Models: „Brauchen jetzt neue Ideen“

AI Kontextualisierung

Welche gesellschaftspolitischen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

KI-Experte Klambauer über Large Language Models: „Brauchen jetzt neue Ideen“

AI Kontextualisierung

Welche wirtschaftlichen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

KI-Experte Klambauer über Large Language Models: „Brauchen jetzt neue Ideen“

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Innovationsmanager:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

KI-Experte Klambauer über Large Language Models: „Brauchen jetzt neue Ideen“

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Investor:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

KI-Experte Klambauer über Large Language Models: „Brauchen jetzt neue Ideen“

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Politiker:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

KI-Experte Klambauer über Large Language Models: „Brauchen jetzt neue Ideen“

AI Kontextualisierung

Was könnte das Bigger Picture von den Inhalten dieses Artikels sein?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

KI-Experte Klambauer über Large Language Models: „Brauchen jetzt neue Ideen“

AI Kontextualisierung

Wer sind die relevantesten Personen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

KI-Experte Klambauer über Large Language Models: „Brauchen jetzt neue Ideen“

AI Kontextualisierung

Wer sind die relevantesten Organisationen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

KI-Experte Klambauer über Large Language Models: „Brauchen jetzt neue Ideen“