07.07.2023

Diese drei Fragen sollten Investor:innen KI-Startups stellen

Gastbeitrag. Worauf Investor:innen achten soll, wenn sie sich Startups im Bereich Künstliche Intelligenz (KI) ansehen, erläutert Simon Brendel von dem auf Tech-Due-Dilligence spezialisierten Beratungsunternehmen Philipps & Byrne.
/artikel/fragen-investoren-ki-startups
Simon Brendel, Philipps & Byrne
Simon Brendel, Philipps & Byrne | Hintergrund: Adobe Stock

Künstliche Intelligenz (und insbesondere Generative AI) gilt aktuell als einer der wenigen Bereiche, die dem allgemeinen Downturn in der Startup-Szene standhalten. Investments in AI sind vergleichsweise stabil und es entstehen immer mehr KI-Startups. VCs, die ihren Dealflow prüfen, stellen sich dabei natürlich oft die Frage, ob die Qualität des Machine-Learning-Setups tatsächlich hält, was das Pitchdeck oder die Equity Story verspricht. In diesem Artikel empfehle ich drei Fragen, die jeder VC auf dem Schirm haben sollte, wenn er sich ein KI-Startup anschaut.

Erste Frage: Handelt es sich wirklich um ML oder um ein traditionelles regelbasiertes System?

Zu Anfang sollte man einmal klären, ob das Startup wirklich mit Machine Learning arbeitet oder eher mit einem selbstentwickelten, regelbasierten System. Ist das System selbstlernend und verbessert es sich, wenn es mit mehr Daten trainiert wird? Dann handelt es sich um ML. Darüber hinaus umfasst selbstlernende ML auch selbstüberwachte oder unüberwachte Methoden. Die Frage, ob und wie man eine solche Selbstverbesserung am besten ermöglicht, wird als „Online-Lernen“ bezeichnet.

Wenn es sich um ein System handelt, das nach bestimmten Regeln arbeitet, die von Entwicklern im Voraus festgelegt werden, und das nicht mit Daten oder selbstlernend trainiert wird, ist das in der Regel keine echte KI – zumindest nicht im aktuellen Verständnis.

Zweite Frage: Make or Buy?

Die zweite Frage lautet: Wurde das ML-Modell selbst entwickelt oder wird ein Open-Source- oder proprietäres Modell von Drittanbietern genutzt? Wenn es sich um Open-Source-Modelle handelt, passen die Unternehmen diese Modelle sehr oft für den eigenen Business-Case an. In diesem Fall wird nicht wirklich etwas von Grund auf neu entwickelt, aber es wird auch nicht einfach etwas übernommen, das bereits existiert. Ein Beispiel wäre die jüngste Entwicklung von ChatGPT, bei der die GPT-Modelle von Open.AI verwendet werden können. Sie sind Open Source, und man kann sie unter bestimmten Lizenzmodellen für das eigene Business nutzen.

Die Unterscheidung besteht also darin, ob es sich um externe ML-Fähigkeiten handelt, die für das eigene Business-Modell genutzt und gegebenfalls angepasst werden, oder ob es sich um selbst entwickelte ML handelt. Bei Letzterem handelt es sich dann in der Regel um Deep-Tech-Startups, die eigene Foundation Models oder Large Language Models (LLM) entwickeln und in denen ein viel tieferes technologisches Wissen im Unternehmen vorhanden ist.

Dritte Frage: Mit welchen Daten wurde das ML-Modell trainiert und wem gehören sie?

ML-Modelle entwickeln sich zunehmend zu einer Ware. Der Zugang zu einem ML-Modell stellt also kein Differenzierungsmerkmal mehr für Startups dar. Die wirklich interessante Frage wird sein, von wem und auf welche Weise diese Modelle trainiert wurden. Und mit welcher Art und Menge von Daten.

Wenn das Unternehmen eigene Daten verwendet, gibt es zwei Dimensionen zu bedenken. Erstens: Die Menge der Datenpunkte im Datensatz. Es geht also darum, zu verstehen, wie statistisch signifikant bestimmte Effekte in diesem Datensatz sind. Ein größerer Datensatz ist immer interessanter, da statistische Fehler besser ausgeschlossen werden können und ein höheres Maß an Vertrauen entsteht. Dabei darf der Aspekt der Datenvielfalt nicht unterschätzt werden. Wie gut decken die verfügbaren Daten den Raum ab, in dem das Model lebt. Einige Unternehmen sind in der Lage, riesige Datensätze aus ihren eigenen Betrieben zu produzieren. Oft besteht aber das Problem, dass Datensätze zu klein sind, um wesentliche Verbesserungen in den Ergebnissen der AI zutage zu fördern.

Die zweite Dimension betrifft die Frage nach den Besitzverhältnissen der Daten. Wie ist das Unternehmen an diesen Datensatz gekommen? Ist er öffentlich zugänglich? Wurden sie von bestimmten Lieferanten bezogen? Oder werden sie vielleicht sogar von dem Unternehmen selbst gesammelt? Proprietäre Daten werden in den kommenden Jahren einen echten Wettbewerbsvorteil darstellen. Je privater der Datensatz ist, desto stärker sind die Fähigkeiten des Unternehmens, einen bestimmten Business Case zu bedienen und damit ein erfolgreiches Geschäftsmodell aufzubauen.

Fazit

Unterm Strich sollten VCs also folgende Fragen auf dem Schirm haben: Zuerst muss man herausfinden, ob das Unternehmen wirklich ML-Modelle vorweisen kann oder ob es sich um regelbasierte Systeme handelt. Zweitens müsste man klären, ob das Modell gekauft oder selbst entwickelt wurde. Und drittens muss hinterfragt werden, mit welchen Daten das Modell trainiert wurde. Und hier gilt: Je größer, vielfältiger und privater der Datensatz ist, desto besser für den Aufbau eines differenzierten Modells und den potenziellen Erfolg eines KI-Startups.


Über den Autor

Simon Brendel ist Director New Business beim Beratungsunternehmen Philipps & Byrne mit Sitz in Berlin, das auf Tech Due Diligence spezialisiert ist. Zur Zielgruppe des Unternehmens zählen Investo:innen, Growth-Stage-Startups und Unternehmer:innen. Brendel thematische Schwerpunkte sind unter anderem Themen Strategie, Technologie und Innovationen.

Deine ungelesenen Artikel:
29.10.2026

Klartext AI: Wiener Startup startet internationale Kooperation gegen Wegwerf-Technik

Das Wiener Startup Klartext AI beteiligt sich an einem internationalen Forschungsprojekt zur Kreislaufwirtschaft in der Elektronikindustrie. Gemeinsam mit Fraunhofer IPA, der Universität Stuttgart und zwei deutschen Industrieunternehmen soll ein KI-gestütztes System entstehen, das Hersteller bei der Entwicklung nachhaltigerer Produkte unterstützt.
/artikel/klartext-ai-wiener-startup-startet-internationale-kooperation-gegen-wegwerf-technik
29.10.2026

Klartext AI: Wiener Startup startet internationale Kooperation gegen Wegwerf-Technik

Das Wiener Startup Klartext AI beteiligt sich an einem internationalen Forschungsprojekt zur Kreislaufwirtschaft in der Elektronikindustrie. Gemeinsam mit Fraunhofer IPA, der Universität Stuttgart und zwei deutschen Industrieunternehmen soll ein KI-gestütztes System entstehen, das Hersteller bei der Entwicklung nachhaltigerer Produkte unterstützt.
/artikel/klartext-ai-wiener-startup-startet-internationale-kooperation-gegen-wegwerf-technik
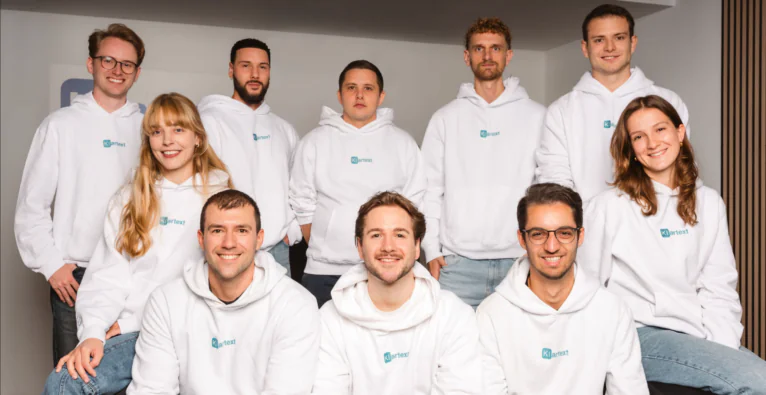
Teamfoto Klartext AI | (c) Leandra Schurz Photography

Elektronikprodukte enthalten wertvolle Rohstoffe, werden aber häufig so entwickelt, dass sie sich nicht einfach reparieren, wiederverwenden oder recyceln lassen. Das Wiener Startup Klartext AI will mit Künstlicher Intelligenz dazu beitragen, das zu ändern. Das 2025 gegründete Unternehmen entwickelt KI-Lösungen für unterschiedliche Anwendungsbereiche, darunter doclarity, ein Tool zur Erstellung barrierefreier PDF-Dokumente. Im Rahmen des Eureka-Forschungsprojekts „ManageR“ entwickelt es einen KI-Assistenten, der Elektronikhersteller bei Entscheidungen zur Kreislaufwirtschaft unterstützen soll. Dafür erhält Klartext AI eine Förderung von rund 250.000 Euro von der Österreichischen Forschungsförderungsgesellschaft (FFG).

Das Projekt startete am 1. Oktober 2026 und läuft über drei Jahre. Klartext AI ist dabei für die KI-Technologie zuständig und entwickelt den sogenannten ‚ManageR Copilot‘. Dieser soll Informationen über Produkte, Materialien und gesetzliche Vorgaben zusammenführen und daraus Handlungsempfehlungen ableiten.

KI soll Reparatur und Wiederverwendung bewerten

Im Mittelpunkt von ManageR steht ein digitales Bewertungs- und Optimierungstool. Dieses soll Unternehmen dabei helfen, für einzelne Produkte und Komponenten geeignete Kreislaufstrategien zu finden. Dabei geht es beispielsweise um die Frage, ob Bauteile repariert, wiederverwendet, aufbereitet oder recycelt werden sollten. Die Software soll in unterschiedlichen Phasen des Produktlebenszyklus zum Einsatz kommen – etwa bei der Entwicklung oder im Einkauf. Je nach Lebenszyklusphase soll das System unterschiedliche Handlungsmöglichkeiten aufzeigen. Neben ökologischen Faktoren soll dabei auch die Wirtschaftlichkeit berücksichtigt werden.

Eine Herausforderung ist dabei die Vielzahl an benötigten Informationen. Dazu zählen etwa Produktstücklisten, Materialdaten, regulatorische Anforderungen und branchenspezifisches Fachwissen. Diese Informationen sind häufig auf unterschiedliche Systeme und Abteilungen verteilt oder liegen bei einzelnen Experten. Das Wiener Startup entwickelt deshalb ein KI-Agentensystem samt Benutzeroberfläche, das die Daten verknüpfen soll. Ein besonderer Schwerpunkt liegt laut Anna Poledna, Business Development bei Klartext AI, auf der Nachvollziehbarkeit: Nutzer sollen erkennen können, auf welchen Informationen und Quellen die Vorschläge beruhen. Technologisch setzt das Startup dafür unter anderem auf Wissensgraphen und Multi-Agenten-Systeme.

Eine Rolle bei der Entstehung des Projekts spielten laut Poledna auch neue EU-Vorgaben. Die Ökodesign-Verordnung (ESPR) soll unter anderem die Langlebigkeit und Reparierbarkeit von Produkten verbessern. Der Digitale Produktpass soll künftig Informationen zu Materialien, Reparaturmöglichkeiten und Umweltauswirkungen verfügbar machen.

Zusammenarbeit mit Fraunhofer und Industrieunternehmen

An ManageR sind neben Klartext AI das Fraunhofer-Institut für Produktionstechnik und Automatisierung (IPA), die Universität Stuttgart sowie die deutschen Unternehmen ifm und Ansmann beteiligt. Fraunhofer koordiniert das Projekt und entwickelt unter anderem ein Bewertungsmodell, während die Universität Stuttgart ihre Expertise in der Ökobilanzierung einbringt. Die beiden Industrieunternehmen stellen ein 3D-Kamerasystem und ein Ladegerät zur Verfügung, an denen die Technologie getestet werden soll.

„Für uns ist es großartig, dass wir unsere KI-Forschung direkt in die Anwendung bringen können. In ManageR entwickeln wir gemeinsam mit führenden Forschungseinrichtungen neue Methoden und testen sie gleichzeitig an echten Industrieprodukten“, sagt Poledna.

Nach Abschluss des Forschungsprojekts im September 2029 soll die Technologie laut Poledna kommerziell angeboten werden. Geplant ist, sie künftig auch für weitere Elektronikprodukte einzusetzen. Wie breit das System anwendbar sein wird, hängt insbesondere von der Verfügbarkeit entsprechender Daten ab.

Toll dass du so interessiert bist!
Hinterlasse uns bitte ein Feedback über den Button am linken Bildschirmrand.
Und klicke hier um die ganze Welt von der brutkasten zu entdecken.

brutkasten Newsletter

Aktuelle Nachrichten zu Startups, den neuesten Innovationen und politischen Entscheidungen zur Digitalisierung direkt in dein Postfach. Wähle aus unserer breiten Palette an Newslettern den passenden für dich.

Montag, Mittwoch und Freitag

AI Summaries

Diese drei Fragen sollten Investor:innen KI-Startups stellen

AI Kontextualisierung

Welche gesellschaftspolitischen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Diese drei Fragen sollten Investor:innen KI-Startups stellen

AI Kontextualisierung

Welche wirtschaftlichen Auswirkungen hat der Inhalt dieses Artikels?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Diese drei Fragen sollten Investor:innen KI-Startups stellen

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Innovationsmanager:in?

Als Innovationsmanager:in ist es wichtig, über aktuelle Trends und Entwicklungen im Startup-Bereich informiert zu sein, um innovative Lösungen und Technologien zu identifizieren und zu nutzen. Der Artikel beschäftigt sich mit dem Thema Künstliche Intelligenz und gibt Investoren wichtige Fragen an die Hand, um die Qualität von KI-Startups zu bewerten. Diese Fragen können auch für Innovationsmanager:innen relevant sein, um potenzielle Kooperationspartner oder Lösungen im KI-Bereich genauer zu prüfen. Es geht dabei um die Unterscheidung zwischen Machine Learning und regelbasierten Systemen, den Ursprung und die Anpassung des ML-Modells sowie die Daten, mit denen das Modell trainiert wurde. Durch das Verständnis dieser Fragen können Innovationsmanager:innen sicherstellen, dass KI-Technologien in ihrer Organisation tatsächlich das halten, was sie versprechen, und eine solide Grundlage für Innovationen schaffen.

Diese drei Fragen sollten Investor:innen KI-Startups stellen

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Investor:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Diese drei Fragen sollten Investor:innen KI-Startups stellen

AI Kontextualisierung

Welche Relevanz hat der Inhalt dieses Artikels für mich als Politiker:in?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Diese drei Fragen sollten Investor:innen KI-Startups stellen

AI Kontextualisierung

Was könnte das Bigger Picture von den Inhalten dieses Artikels sein?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Diese drei Fragen sollten Investor:innen KI-Startups stellen

AI Kontextualisierung

Wer sind die relevantesten Personen in diesem Artikel?

  • Autor: Simon Brendel

Diese drei Fragen sollten Investor:innen KI-Startups stellen

AI Kontextualisierung

Wer sind die relevantesten Organisationen in diesem Artikel?

Leider hat die AI für diese Frage in diesem Artikel keine Antwort …

Diese drei Fragen sollten Investor:innen KI-Startups stellen